

Jedes KI-Modell lebt zwei Leben. Zuerst lernt es: Im Training sieht es große Datenmengen und passt seine inneren Zahlen an, immer wieder, bis seine Vorhersagen gut sind. Dann arbeitet es: In der Inferenz bekommt das fertige Modell eine neue Eingabe, etwa Ihre Frage, und erzeugt eine Ausgabe, ohne dabei etwas Neues zu lernen. Die beiden Phasen unterscheiden sich in fast allem: wer zahlt, wie lange sie dauern, welche Hardware sie brauchen und was schiefgehen kann.
Dies ist Teil 3 von Level 0 in unserem Lernpfad KI-Grundlagen. Sie erfahren, was in jeder Phase passiert, warum das Training eines Spitzenmodells zu einem Industrieprojekt geworden ist und warum auch die Inferenz, der scheinbar günstige Teil, große Kosten verursacht.
Zwei Phasen jedes Modells
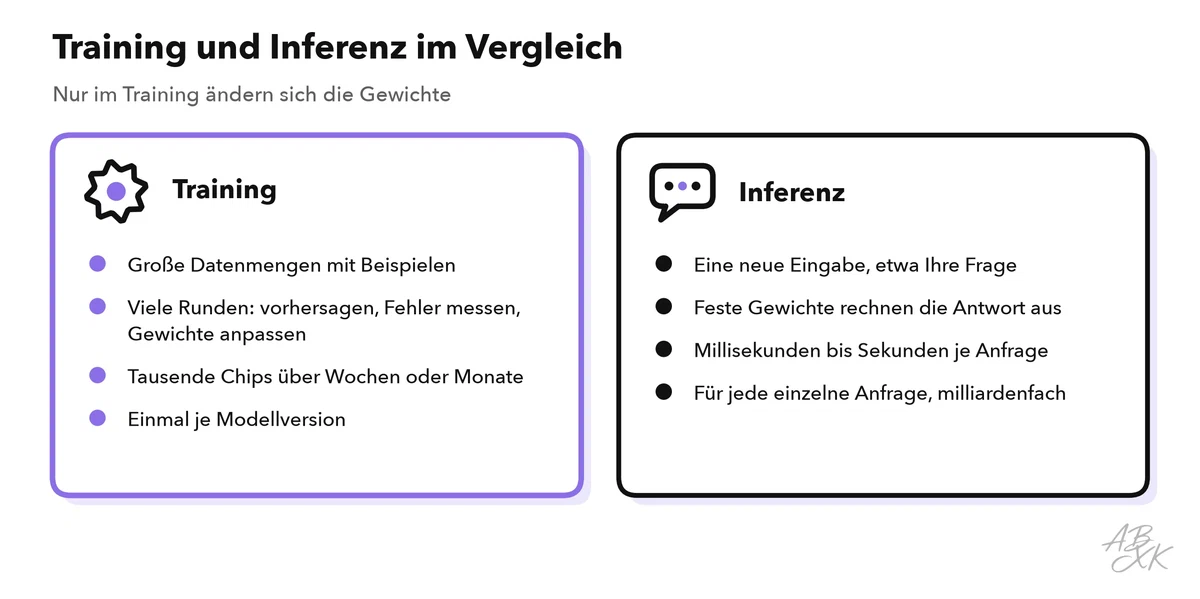
Im Training macht das Modell eine Vorhersage für ein Beispiel, eine Formel misst den Fehler, und ein Algorithmus namens Backpropagation berechnet, wie sich jedes Gewicht ändern müsste, damit der Fehler kleiner wird. Dann bewegen sich alle Gewichte ein kleines Stück in diese Richtung. Ein Durchgang durch alle Trainingsdaten heißt Epoche, und ein Modell braucht meist viele davon. Das kleine Netz in unserem Ziffern-Experiment etwa durchlief 200 Runden der Anpassung.
In der Inferenz bleiben die Gewichte fest. Das Modell rechnet nur: Eingabe hinein, Ausgabe heraus. Ein Sprachmodell tut das einmal für jedes Token, ungefähr jedes Wortstück, seiner Antwort — deshalb dauern lange Antworten länger und kosten mehr.
| Training | Inferenz | |
|---|---|---|
| Was passiert | Gewichte werden angepasst, um den Fehler zu senken | Feste Gewichte machen aus einer Eingabe eine Ausgabe |
| Wie oft | Einmal je Modellversion, dazu Aktualisierungen | Für jede einzelne Anfrage |
| Dauer | Tage bis Monate bei großen Modellen | Millisekunden bis Sekunden je Anfrage |
| Hardware | Tausende Chips in enger Zusammenarbeit | Weniger Chips je Anfrage, verteilt auf viele Rechenzentren |
| Wer zahlt | Der Entwickler des Modells | Die Nutzer, über den Preis je Token oder ein Abo |
| Typisches Risiko | Schlechte oder verzerrte Trainingsdaten | Falsche Antworten, Datenabfluss, langsame Antworten |
Wie groß Trainingsläufe geworden sind
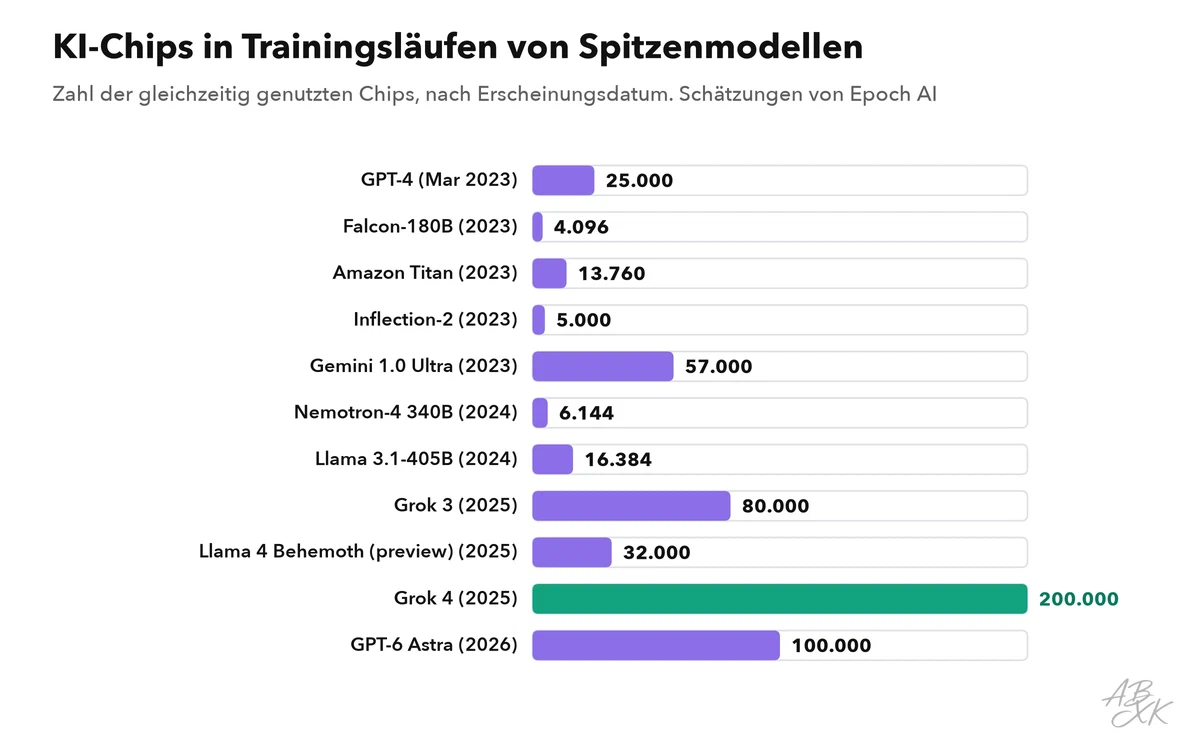
Der Rechenaufwand des Trainings, die Zahl der Rechenoperationen eines Trainingslaufs, ist schnell gewachsen. Über die bemerkenswerten Modelle, die das Forschungsinstitut Epoch AI seit 2010 erfasst hat, wuchs er um etwa das 4,3-Fache pro Jahr — unsere Berechnung aus den Daten von Epoch AI. Die Trainingsläufe hinter den heutigen Spitzenmodellen sind Industrieprojekte:
| Modell | Organisation | Veröffentlicht | Chips | Trainingstage | Rechenkosten (Mio. US-$ von 2023) | Leistung (MW) |
|---|---|---|---|---|---|---|
| GPT-6 Astra | OpenAI | 03.09.2026 | 100.000 | – | – | 233 |
| Grok 4 | xAI | 09.07.2025 | 200.000 | – | 388 | – |
| Llama 4 Behemoth (preview) | Meta AI | 05.04.2025 | 32.000 | – | 45 | 44 |
| GPT-4.5 | OpenAI | 27.02.2025 | – | 125 | 366 | – |
| Grok 3 | xAI | 17.02.2025 | 80.000 | 90 | 218 | 110 |
| Llama 3.1-405B | Meta AI | 23.07.2024 | 16.384 | 89 | 53 | 23 |
| Nemotron-4 340B | Nvidia | 14.06.2024 | 6.144 | 92 | 21 | 9 |
| Gemini 1.0 Ultra | Google DeepMind | 06.12.2023 | 57.000 | 100 | 31 | 38 |
| Inflection-2 | Inflection AI | 22.11.2023 | 5.000 | – | 14 | 7 |
| Amazon Titan | Amazon | 28.09.2023 | 13.760 | 48 | 8 | 11 |
| Falcon-180B | Technology Innovation Institute | 06.09.2023 | 4.096 | 180 | 11 | 3 |
| GPT-4 (Jun 2023) | OpenAI | 13.06.2023 | 25.000 | 95 | – | 20 |
| GPT-4 (Mar 2023) | OpenAI | 15.03.2023 | 25.000 | 95 | 37 | 20 |
Daten: Epoch AI, Data on AI models (1078 bemerkenswerte Modelle), abgerufen am 18.10.2026, Lizenz CC BY 4.0; unsere Auswertung.
Der größte Lauf in den Daten nutzte rund 200.000 KI-Chips gleichzeitig, und die höchsten geschätzten Rechenkosten liegen bei etwa 388 Millionen Dollar, gerechnet in Dollar von 2023 und nur für die Rechenzeit, nicht für Forschende oder Daten. Der stromhungrigste Lauf zog während des Trainings geschätzt 233 Megawatt.
Training nach dem Training: Fine-Tuning und Rückmeldung
Der große Trainingslauf ist nur die erste Stufe. Ein Sprachmodell durchläuft zuerst das Pretraining: Es liest riesige Textmengen und lernt, das nächste Wortstück vorherzusagen. Das Ergebnis weiß viel, folgt aber noch nicht gut Anweisungen. Beim Fine-Tuning trainiert der Entwickler es mit einer viel kleineren Menge guter Beispiele weiter, etwa Fragen mit Musterantworten, die Menschen geschrieben haben. Dann folgt Reinforcement Learning from Human Feedback (RLHF) oder ein ähnliches Verfahren: Menschen oder ein anderes Modell vergleichen Antwortpaare, und das Modell wird für die bevorzugte Antwort belohnt. Neuere Reasoning-Modelle lernen zusätzlich aus Belohnungen für richtig gelöste Mathe- und Programmieraufgaben. Diese späteren Stufen brauchen weit weniger Rechenaufwand als das Pretraining, prägen aber das meiste dessen, was Nutzer bemerken: den Ton, wann das Modell ablehnt und wie es Schritt für Schritt argumentiert.
Warum sich die Kosten der Inferenz summieren
Eine einzelne Antwort eines Sprachmodells kostet den Bruchteil eines Cents. Doch beliebte KI-Dienste beantworten Milliarden Anfragen, jeden Tag, und jeder neue Nutzer, jede längere Antwort und jedes Modell, das vor der Antwort Schritt für Schritt „nachdenkt“, kostet zusätzliche Rechenzeit. Über die Lebensdauer eines erfolgreichen Modells kann die Inferenz mehr kosten als das Training. Deshalb stecken Entwickler so viel Aufwand in günstigere Inferenz: kleinere Modelle für einfache Aufgaben, komprimierte Gewichte mit weniger Bits je Zahl und gespeicherte Antworten, die bei wiederholten Fragen erneut genutzt werden.
Inferenz auf dem eigenen Gerät
Inferenz muss nicht im Rechenzentrum stattfinden. Kleine Modelle laufen auf Laptops und Handys, wo sie antworten, ohne Daten irgendwohin zu schicken — das hilft beim Datenschutz und funktioniert offline. Die Grenze ist der Speicher: Jedes Gewicht muss geladen werden, ein Modell mit 8 Milliarden Parametern braucht also selbst mit komprimierten Gewichten mehrere Gigabyte. Deshalb führen Handys kleine Modelle für Aufgaben wie das Zusammenfassen von Benachrichtigungen aus und geben schwierigere Fragen an ein größeres Modell in der Cloud ab. Für Unternehmen ist ein offenes Modell auf eigenen Servern der Mittelweg: Die Daten bleiben im Haus, aber jemand muss die Hardware kaufen und betreiben.
Was das für Ihre Projekte bedeutet
Nutzen Sie ein KI-Modell über eine API, zahlen Sie nur die Inferenz, abgerechnet je Token oder je Anfrage. Trainieren werden Sie selten selbst; höchstens passen Sie ein vorhandenes Modell per Fine-Tuning an, einem kurzen zusätzlichen Training mit Ihren eigenen Beispielen. Die praktischen Fragen lauten daher: Wie viele Anfragen werden Sie senden? Wie lang sind Eingaben und Antworten? Reicht ein kleineres, günstigeres Modell? Wie Sie sie beantworten, zeigt unser Lernpfad AI Development im Artikel zu APIs, Tokens und Kontextfenstern.
Der nächste Teil dieses Levels betrachtet die drei Größen hinter dem Wachstum der KI-Modelle: Parameter, Daten und Rechenaufwand.