

Wie viele Stück verkaufen wir nächsten Monat? Wie lange dauert diese Lieferung? Was wird diese Wohnung kosten? Immer wenn die Antwort eine Zahl ist, heißt das passende Werkzeug des maschinellen Lernens Regression. Sie ist das älteste Verfahren in diesem Lernpfad, weit älter als Computer, und sie steckt bis heute überall: in Absatzprognosen, in der Preisgestaltung, in den Planungswerkzeugen fast jedes Unternehmens.
Dies ist Teil 1 von Level 1 in unserem Lernpfad KI-Grundlagen. Statt des üblichen Beispiels mit Wohnungspreisen nutzen wir eine Frage aus der KI-Welt selbst: Lässt sich aus der Zahl der Parameter vorhersagen, wie viel Rechenleistung das Training eines KI-Modells gekostet hat? Sie erfahren, was eine Regressionslinie ist, wie Sie ihre Steigung lesen, was R² aussagt und warum die Punkte, die die Linie verfehlen, oft die interessantesten sind.
Eine Linie durch die Daten
Epoch AI, ein Forschungsinstitut, das die Entwicklung der KI verfolgt, erfasst für 475 bemerkenswerte KI-Modelle sowohl die Parameter als auch den Rechenaufwand des Trainings. Beide Zahlen reichen über viele Größenordnungen, von ein paar Dutzend Parametern bis zu Billionen. Wir zeichnen sie deshalb auf logarithmischen Skalen, auf denen jede Stufe das Zehnfache bedeutet. So aufgetragen reihen sich die Modelle erstaunlich gut auf.
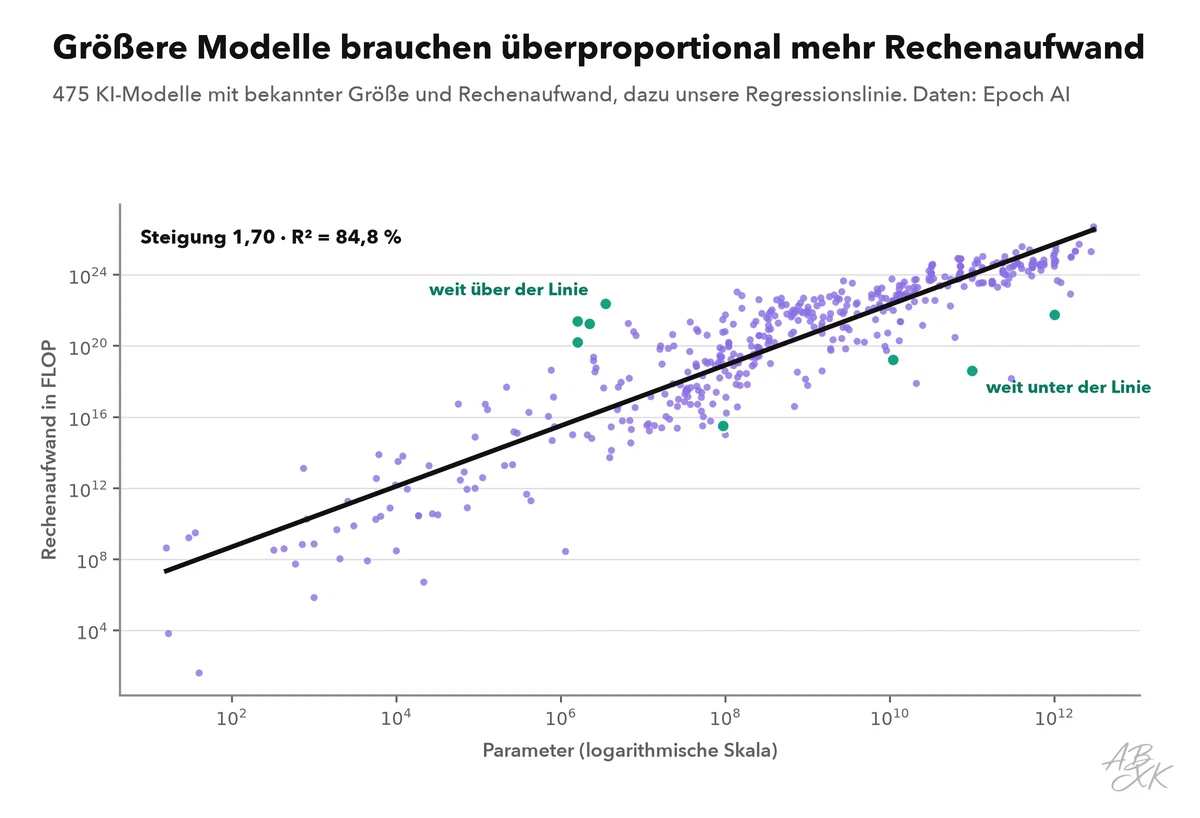
Die lineare Regression zieht die gerade Linie, die am besten zu den Punkten passt. „Am besten“ ist genau festgelegt: die Linie mit der kleinsten Summe der quadrierten senkrechten Abstände zu den Punkten, die Methode der kleinsten Quadrate. Beschrieben wird die Linie durch zwei Zahlen. Der Achsenabschnitt sagt, wo sie beginnt; die Steigung, wie steil sie ist. Unsere Linie hat eine Steigung von 1,70. Auf logarithmischen Skalen heißt das: Ein Modell mit zehnmal so vielen Parametern brauchte im Schnitt etwa 50-mal so viel Rechenaufwand. Größere Modelle kosten im Training also nicht nur mehr, sondern überproportional mehr — weil sie meist auch mit mehr Daten trainiert werden.
| Begriff | Was er bedeutet | In unserem Beispiel |
|---|---|---|
| Merkmal (Feature) | Die Eingabe, die das Modell nutzt | Zahl der Parameter (logarithmisch) |
| Zielgröße (Target) | Die Zahl, die vorhergesagt wird | Rechenaufwand des Trainings (logarithmisch) |
| Steigung | Wie stark sich die Zielgröße je Stufe des Merkmals ändert | Zehnmal so viele Parameter, rund 50-mal so viel Rechenaufwand |
| Achsenabschnitt | Wo die Linie die Achse schneidet | Rechenaufwand eines gedachten Modells mit einem Parameter |
| Residuum | Abstand eines Punktes von der Linie | Wie weit ein Modell über oder unter der Vorhersage liegt |
| R² | Anteil der Streuung, den die Linie erklärt | Siehe unten |
Wie gut ist die Linie?
Das Bestimmtheitsmaß R² misst, wie viel der Streuung in den Daten die Linie erklärt: 0 % heißt, die Linie ist nutzlos, 100 %, jeder Punkt liegt genau darauf. Unsere Linie erklärt 84,8 % der Streuung des Rechenaufwands. Für echte Daten ist das viel. Trotzdem kann eine einzelne Vorhersage weit danebenliegen: Im Schnitt weicht der tatsächliche Rechenaufwand um etwa den Faktor 17,4 von der Linie ab, nach oben oder unten. Beides stimmt zugleich. Die Linie erfasst den großen Trend über viele Größenordnungen; für ein bestimmtes Modell ist sie nur eine grobe erste Schätzung.
Die Punkte, die die Linie verfehlen
Wer die Residuen betrachtet, die Abstände zwischen Punkten und Linie, sieht, was das Modell auslässt. Nur 53,5 % der Modelle liegen innerhalb eines Faktors zehn um die Linie, und 33 verfehlen sie um mehr als das Tausendfache.
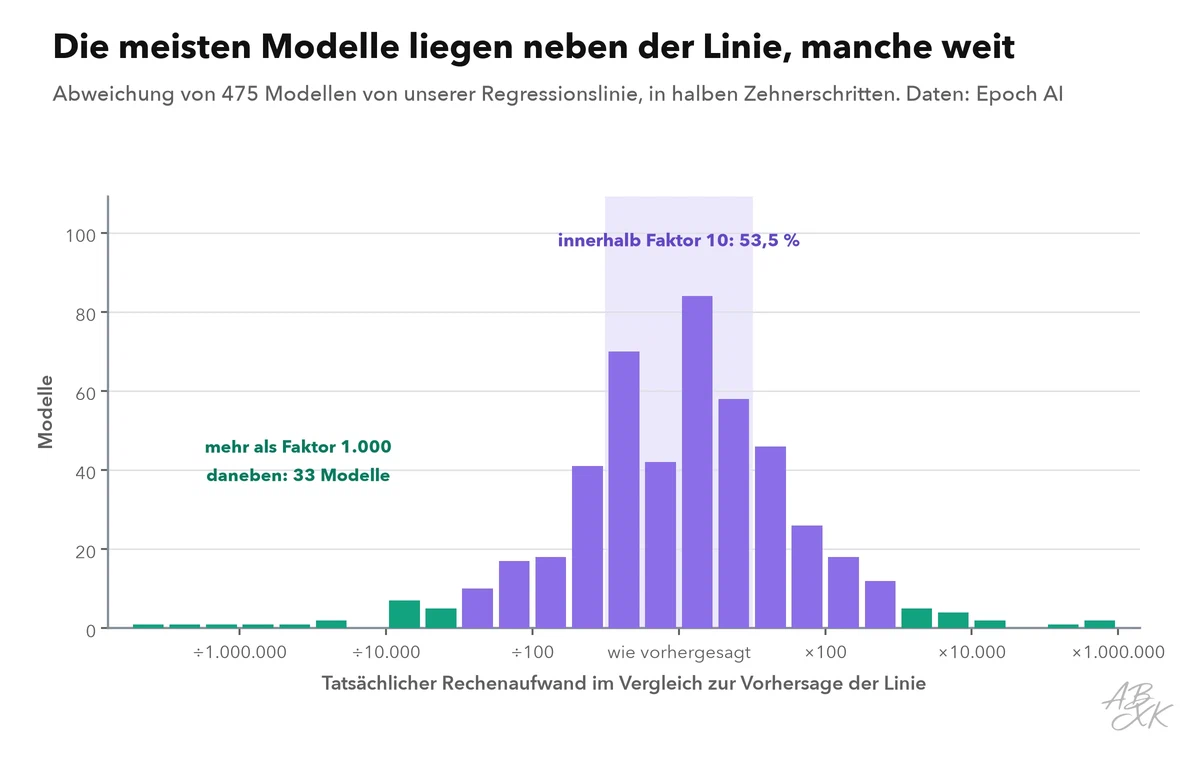
Die Modelle weit über und weit unter unserer Linie sind kein Zufall.
| Modell | Organisation | Jahr | Parameter | Tatsächlicher Rechenaufwand im Vergleich zur Linie |
|---|---|---|---|---|
| GOAT | DeepMind | 2021 | 3,5 × 10⁶ | 891.251-mal so viel |
| StyleGAN3-R | Nvidia | 2021 | 1,6 × 10⁶ | 346.737-mal so viel |
| StyleGAN3-T | Nvidia | 2021 | 2,2 × 10⁶ | 134.896-mal so viel |
| IMPALA | DeepMind | 2018 | 1,6 × 10⁶ | 23.442-mal so viel |
| DLRM-2020 | Facebook AI | 2019 | 1,0 × 10¹¹ | 263.027-mal weniger |
| M6-T | Alibaba | 2021 | 1,0 × 10¹² | 9.550-mal weniger |
| ELMo | University of Washington | 2018 | 9,3 × 10⁷ | 2.239-mal weniger |
| UnifiedQA | Allen Institute for AI | 2020 | 1,1 × 10¹⁰ | 1.479-mal weniger |
Daten: Epoch AI, Data on AI models (1078 bemerkenswerte Modelle), abgerufen am 18.10.2026, Lizenz CC BY 4.0; unsere Auswertung.
Weit über der Linie liegen kleine Netze, die ungewöhnlich lange trainiert wurden: Agenten, die Spiele und Aufgaben durch bestärkendes Lernen gelernt haben, Millionen Runden Versuch und Irrtum, und Bildgeneratoren vom Typ GAN, die ebenfalls viele Schritte trainieren. Weit unter der Linie liegen Modelle mit riesigen Parameterzahlen, die je Beispiel nur wenig genutzt werden: ein Empfehlungsmodell, dessen Parameter größtenteils große Nachschlagetabellen sind, und ein Sprachmodell nach dem Mixture-of-Experts-Prinzip, bei dem für jedes Wort nur ein kleiner Teil des Netzes aktiv ist. In beiden Fällen sagt die Zahl der Parameter wenig über die Arbeit im Training.
Das ist die zweite Lehre der Regression: Ein Modell ist nur so gut wie seine Merkmale. Die Parameter allein erklären viel, doch die Menge der Trainingsdaten als zweites Merkmal würde mehr erklären — genau das tun Forschende, wenn sie untersuchen, wie KI-Modelle skalieren.
Regression in der Praxis
Regression ist oft das richtige erste Werkzeug, auch in Projekten, die später zu aufwendigeren Modellen wechseln:
- Einfach anfangen. Eine lineare Regression trainiert in Millisekunden, und ihre Steigung kann jeder lesen und prüfen. Aufwendigere Verfahren müssen sie erst schlagen, bevor sie ihren Platz verdienen.
- Die Residuen prüfen. Folgen die Abweichungen einem Muster, etwa im Winter immer zu niedrig, fehlt ein Merkmal.
- Nicht weit extrapolieren. Eine Linie, die an die Vergangenheit angepasst wurde, sagt wenig über Werte weit außerhalb der Daten. Unsere Linie stützt sich auf Modelle bis zu den heute größten; wie viel Rechenaufwand ein zehnmal größeres Modell bräuchte, kann sie nicht sagen.
- Zusammenhang ist nicht Ursache. Die Linie zeigt, dass Parameter und Rechenaufwand gemeinsam steigen, nicht, dass das eine das andere verursacht. Beides folgt aus der Entscheidung, ein größeres Modell zu bauen.
Wie man die Qualität eines Modells misst, das statt einer Zahl eine Kategorie vorhersagt, ist Thema des nächsten Teils: Klassifikation und ihre Kennzahlen.