

Wenn ein neues KI-Modell angekündigt wird, kommen meist drei Zahlen mit: wie viele Parameter es hat, mit wie vielen Daten es trainiert wurde und wie viel Rechenleistung sein Training brauchte. Diese drei Zahlen erklären den größten Teil des Fortschritts der letzten fünfzehn Jahre. Die Ideen hinter den heutigen Modellen sind kaum jünger als der Transformer von 2017; was sich geändert hat, ist der Maßstab.
Dies ist Teil 4 von Level 0 in unserem Lernpfad KI-Grundlagen. Sie erfahren, was jede der drei Zahlen bedeutet, wie schnell jede laut den Daten von Epoch AI zu bemerkenswerten KI-Modellen gewachsen ist und warum größer bisher besser hieß.
Drei Zahlen hinter jedem Modell
Parameter sind die einstellbaren Zahlen in einem Modell, seine Gewichte. Sie speichern, was das Modell gelernt hat. Unser kleines Ziffern-Netz hatte einige Tausend; große Sprachmodelle haben Milliarden oder, nach Schätzungen, mehr als eine Billion.
Trainingsdaten sind die Beispiele, aus denen ein Modell lernt. Bei Sprachmodellen werden sie in Tokens gezählt, Wortstücken von im Englischen etwa vier Zeichen, und reichen heute in die Billionen.
Rechenaufwand des Trainings ist die Zahl der Rechenoperationen im gesamten Training, gezählt in FLOP (Floating-Point Operations, einfache Rechnungen mit Kommazahlen). Er hängt von den beiden anderen ab: Eine verbreitete Faustregel für Transformer-Modelle lautet, dass der Rechenaufwand etwa sechsmal die Zahl der Parameter mal die Zahl der Trainings-Tokens beträgt. Ein doppelt so großes Modell mit doppelt so vielen Daten braucht also etwa viermal so viel Rechenaufwand.
| Zahl | Was sie misst | Einheit | Wächst, wenn |
|---|---|---|---|
| Parameter | Einstellbare Gewichte des Modells | Anzahl | Das Modell größer wird |
| Trainingsdaten | Beispiele, aus denen das Modell lernt | Tokens, Bilder, Datenpunkte | Mehr Daten gesammelt werden |
| Rechenaufwand | Rechenoperationen des gesamten Trainings | FLOP | Eine der beiden anderen wächst oder länger trainiert wird |
Wie schnell sie wuchsen
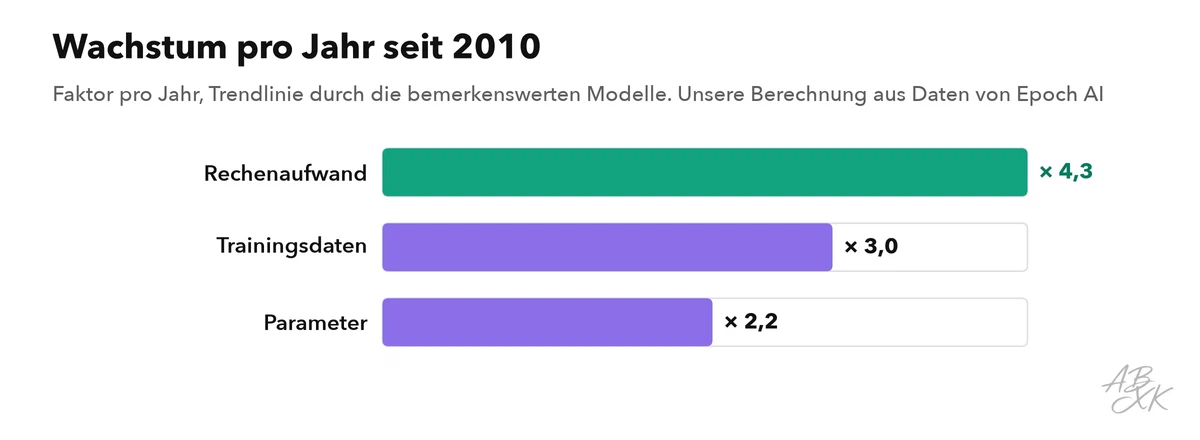
Epoch AI, ein Forschungsinstitut, das die Entwicklung der KI verfolgt, schätzt den Rechenaufwand des Trainings für 478 seiner bemerkenswerten Modelle. Wir haben eine Trendlinie durch die seit 2010 veröffentlichten Modelle gelegt. Das Ergebnis: Der Rechenaufwand wuchs um etwa das 4,3-Fache pro Jahr, er verdoppelte sich also ungefähr alle 5,7 Monate. Die Parameter wuchsen um etwa das 2,2-Fache pro Jahr, die Trainingsdaten um etwa das 3-Fache.
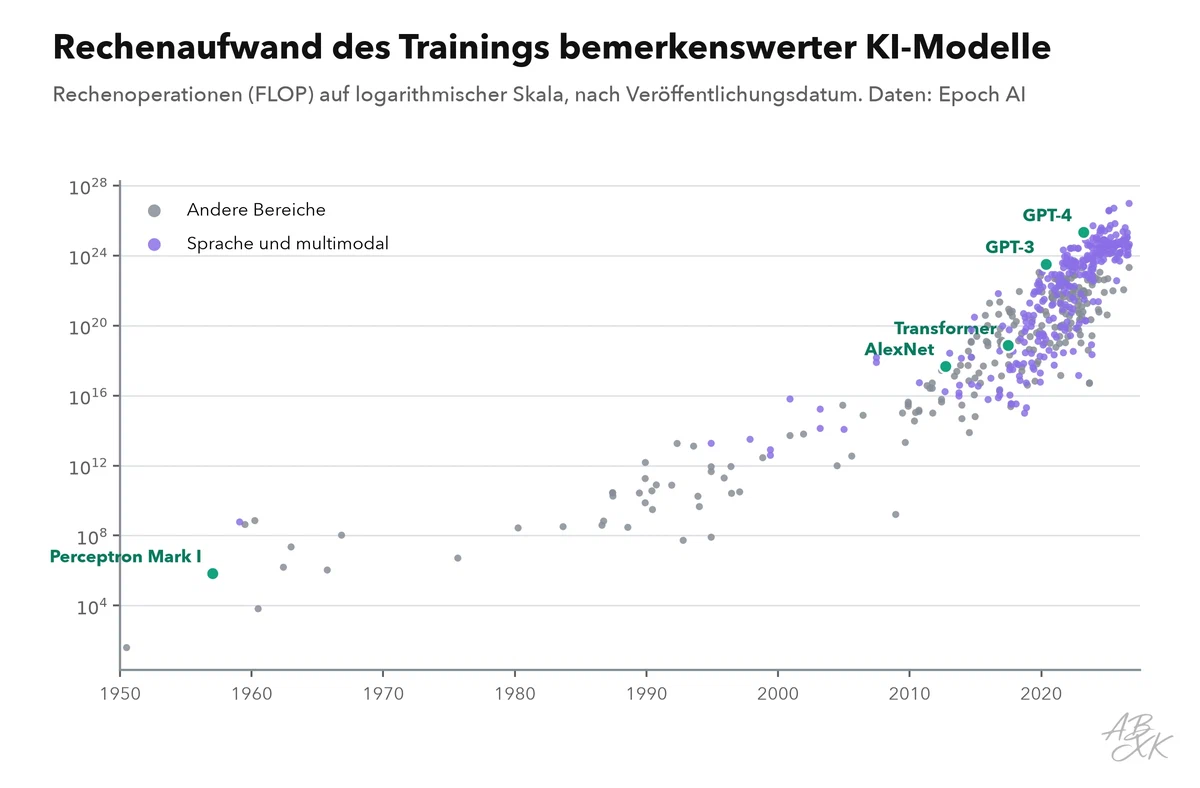
Der Rechenaufwand wächst am schnellsten, weil er die beiden anderen verbindet: größere Modelle, mit mehr Daten länger trainiert. Zum Vergleich: Die Rechenleistung eines einzelnen Chips wuchs weit langsamer; der Rest kam daher, dass viel mehr Chips gleichzeitig genutzt werden, wie Teil 3 dieses Levels gezeigt hat.
Woher die Trainingsdaten kommen
Bei Sprachmodellen stammt der größte Teil der Trainingsdaten aus Texten des öffentlichen Webs, gesammelt von Crawlern und stark gefiltert: Dubletten, Spam und minderwertige Seiten fliegen raus, weil die Qualität so viel zählt wie die Menge. Bücher, Fachartikel, Code aus öffentlichen Repositorys und abgeschriebene Tonaufnahmen kommen hinzu. Bild- und Videomodelle lernen aus Bildern und Clips mit passenden Beschreibungen. Zwei Entwicklungen prägen diese Daten heute. Entwickler nutzen zunehmend synthetische Daten, also Beispiele, die andere Modelle erzeugt haben, etwa Matheaufgaben mit Lösungsweg. Und die Nutzung urheberrechtlich geschützter Werke fürs Training ist umstritten: Gerichtsverfahren und neue Regeln klären, was genutzt werden darf, und der EU AI Act verpflichtet Anbieter von KI-Modellen mit allgemeinem Verwendungszweck, eine Zusammenfassung der Trainingsinhalte zu veröffentlichen.
Warum die Zahl der Parameter täuschen kann
Mehr Parameter heißt nicht immer ein besseres oder teureres Modell. Viele große Modelle sind heute Mixtures of Experts: Sie enthalten viele spezialisierte Teilnetze, und für jedes Wortstück sind nur wenige davon aktiv. Ein solches Modell kann insgesamt Hunderte Milliarden Parameter haben, nutzt aber für jede Antwort nur einen Bruchteil davon — und ist dadurch viel günstiger im Betrieb. In die andere Richtung trainiert die Destillation ein kleines Modell darauf, ein großes nachzuahmen, sodass ein Modell mit wenigen Milliarden Parametern viel größere Modelle von vor ein, zwei Jahren erreichen kann. Wenn Sie Modelle vergleichen, schauen Sie auf Benchmark-Ergebnisse und Preise, nicht allein auf die Zahl der Parameter.
Die größten Trainingsläufe
Die Tabelle zeigt die bemerkenswerten Modelle mit dem größten Rechenaufwand. Die Zahlen sind Schätzungen von Epoch AI, weil Entwickler sie selten veröffentlichen. Der größte Lauf in den Daten brauchte etwa 10 hoch 27,0 Rechenoperationen — eine Eins mit mehr als zwei Dutzend Nullen.
| Modell | Organisation | Veröffentlicht | Rechenaufwand (FLOP) | Bereich |
|---|---|---|---|---|
| GPT-6 Astra | OpenAI | 03.09.2026 | 9,3 × 1026 | Multimodal |
| Grok 4 | xAI | 09.07.2025 | 5,0 × 1026 | Sprache |
| GPT-4.5 | OpenAI | 27.02.2025 | 3,8 × 1026 | Sprache |
| Grok 3 | xAI | 17.02.2025 | 3,5 × 1026 | Sprache |
| GPT-5 | OpenAI | 07.08.2025 | 6,6 × 1025 | Multimodal |
| Llama 4 Behemoth (preview) | Meta AI | 05.04.2025 | 5,1 × 1025 | Multimodal |
| Gemini 1.0 Ultra | Google DeepMind | 06.12.2023 | 5,0 × 1025 | Multimodal |
| Composer 2.5 | Cursor | 18.05.2026 | 3,9 × 1025 | Sprache |
| Llama 3.1-405B | Meta AI | 23.07.2024 | 3,8 × 1025 | Sprache |
| Claude 3.7 Sonnet | Anthropic | 24.02.2025 | 3,4 × 1025 | Sprache |
Daten: Epoch AI, Data on AI models (1078 bemerkenswerte Modelle), abgerufen am 18.10.2026, Lizenz CC BY 4.0; unsere Auswertung.
Warum größer besser hieß
Seit etwa 2020 haben Forschende festgestellt, dass der Fehler von Sprachmodellen erstaunlich regelmäßig sinkt, wenn Rechenaufwand, Parameter und Daten gemeinsam wachsen. Diese Skalierungsgesetze erlauben es Entwicklern, vorherzusagen, wie gut ein Modell wird, bevor sie es trainieren — und sie erklären, warum Unternehmen Milliarden in immer größere Trainingsläufe stecken. Eine zweite Erkenntnis prägte das Feld: Bei gegebenem Rechenaufwand lohnt es sich, Modellgröße und Datenmenge auszubalancieren, statt das größtmögliche Modell mit zu wenig Daten zu bauen.
Das Wachstum hat Grenzen. Trainingsläufe brauchen jedes Jahr mehr Chips, mehr Strom und mehr Daten, und hochwertiger Text aus dem Internet ist endlich. Deshalb suchen Entwickler inzwischen auch nach anderen Wegen, Modelle zu verbessern, etwa indem sie sie vor der Antwort länger „nachdenken“ lassen — das verlagert Rechenaufwand vom Training in die Inferenz.
Der letzte Teil von Level 0 öffnet die Kiste: was ein neuronales Netz eigentlich ist, mit den Neuronen, Schichten und Gewichten unseres eigenen kleinen Netzes.