

Neuronale Netze stecken hinter fast jedem KI-Durchbruch der letzten Jahre, von der Bilderkennung bis zu großen Sprachmodellen. Der Name klingt nach Biologie, die Idee ist aber einfache Rechnung: viele kleine Rechenschritte, in Schichten verbunden, mit Zahlen, die das Netz beim Lernen anpasst. Um zu zeigen, was das heißt, haben wir selbst ein kleines Netz gebaut, trainiert und seine Größe Schritt für Schritt verändert.
Dies ist Teil 5, der letzte Teil von Level 0 in unserem Lernpfad KI-Grundlagen. Sie erfahren, was ein einzelnes künstliches Neuron berechnet, wie Neuronen Schichten bilden, was die Gewichte sind und was mit der Genauigkeit unseres Netzes geschah, als wir ihm mehr oder weniger Neuronen gaben.
Ein Neuron: gewichtete Summe und Schalter
Ein künstliches Neuron tut zwei Dinge. Erstens multipliziert es jede seiner Eingaben mit einem Gewicht und zählt alles zusammen, dazu eine Konstante, den Bias. Ein großes positives Gewicht heißt „diese Eingabe zählt und treibt das Ergebnis nach oben“, ein negatives Gewicht „sie drückt es nach unten“. Zweitens schickt es die Summe durch eine Aktivierungsfunktion, eine einfache Regel wie „ist die Summe negativ, gib null aus, sonst die Summe“. Dieser schalterartige Schritt erlaubt es Netzen, Muster zu lernen, die nicht nur gerade Linien sind.
Das ist alles. Ein Neuron allein ist viel zu einfach, um eine Ziffer zu erkennen. Die Stärke entsteht, wenn man viele verbindet.
Schichten: von Pixeln zu Ziffern
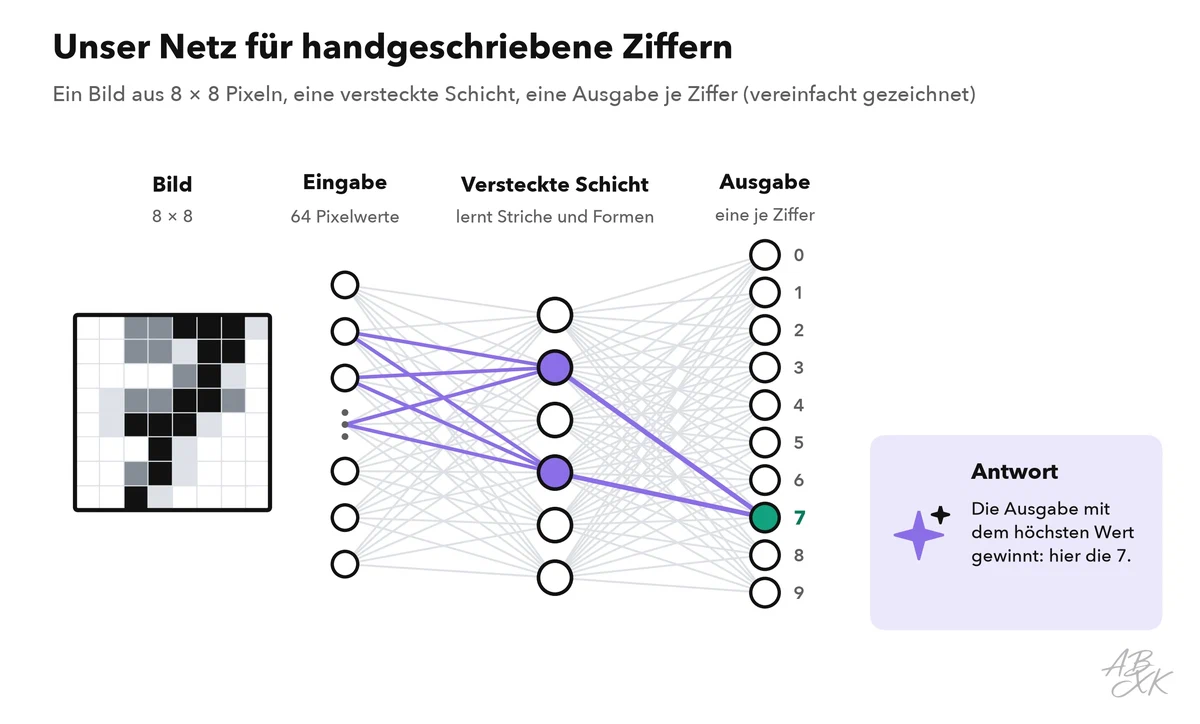
Unser Netz liest die handgeschriebenen Ziffern aus Teil 2 dieses Levels: Bilder aus 8 × 8 = 64 Pixeln. Die Eingabeschicht nimmt die 64 Helligkeitswerte auf. Eine versteckte Schicht von Neuronen kombiniert sie; jedes ihrer Neuronen ist mit allen 64 Eingaben verbunden und lernt, auf einen bestimmten Strich oder eine Form zu reagieren. Die Ausgabeschicht hat 10 Neuronen, eines je Ziffer, und das mit dem höchsten Wert ist die Antwort des Netzes. „Versteckt“ heißt nur, dass man diese Werte nie direkt sieht; es sind die inneren Merkmale des Netzes.
Deep Learning stapelt viele versteckte Schichten. In Bildnetzen reagieren die ersten Schichten auf Kanten, spätere auf Formen und die letzten auf ganze Gegenstände — eine Rangordnung, die das Netz beim Training selbst findet.
Gewichte: was das Netz lernt
Jede Verbindung hat ein Gewicht, jedes Neuron einen Bias. Zusammen sind das die Parameter des Netzes. Das Training, erklärt in Teil 3, passt sie an: Das Netz sagt eine Ziffer vorher, eine Formel misst, wie falsch es lag, und ein Algorithmus namens Backpropagation berechnet, wie sich jedes Gewicht ändern müsste, damit der Fehler kleiner wird. Unser Netz mit 64 versteckten Neuronen hat 4.810 solcher Zahlen. Ein großes Sprachmodell hat Milliarden, aber jede spielt dieselbe Rolle.
| Teil | Was es ist | In unserem Netz |
|---|---|---|
| Eingabeschicht | Die Rohdaten als Zahlen | 64 Helligkeitswerte der Pixel |
| Versteckte Schicht | Neuronen, die die Eingaben zu Merkmalen kombinieren | Zwischen 1 und 128 Neuronen |
| Ausgabeschicht | Ein Neuron je möglicher Antwort | 10 Neuronen, Ziffern 0 bis 9 |
| Gewichte und Bias | Die Zahlen, die das Training anpasst | Einige Dutzend bis mehrere Tausend |
| Aktivierungsfunktion | Der Schalter in jedem Neuron | Negative Summen werden zu null |
Unser Experiment: Wie viele Neuronen braucht es?
Wir haben dasselbe Netz mit 1, 2, 4, 8, 16, 32, 64 und 128 Neuronen in der versteckten Schicht trainiert und jede Version an Bildern getestet, die sie nie gesehen hatte.
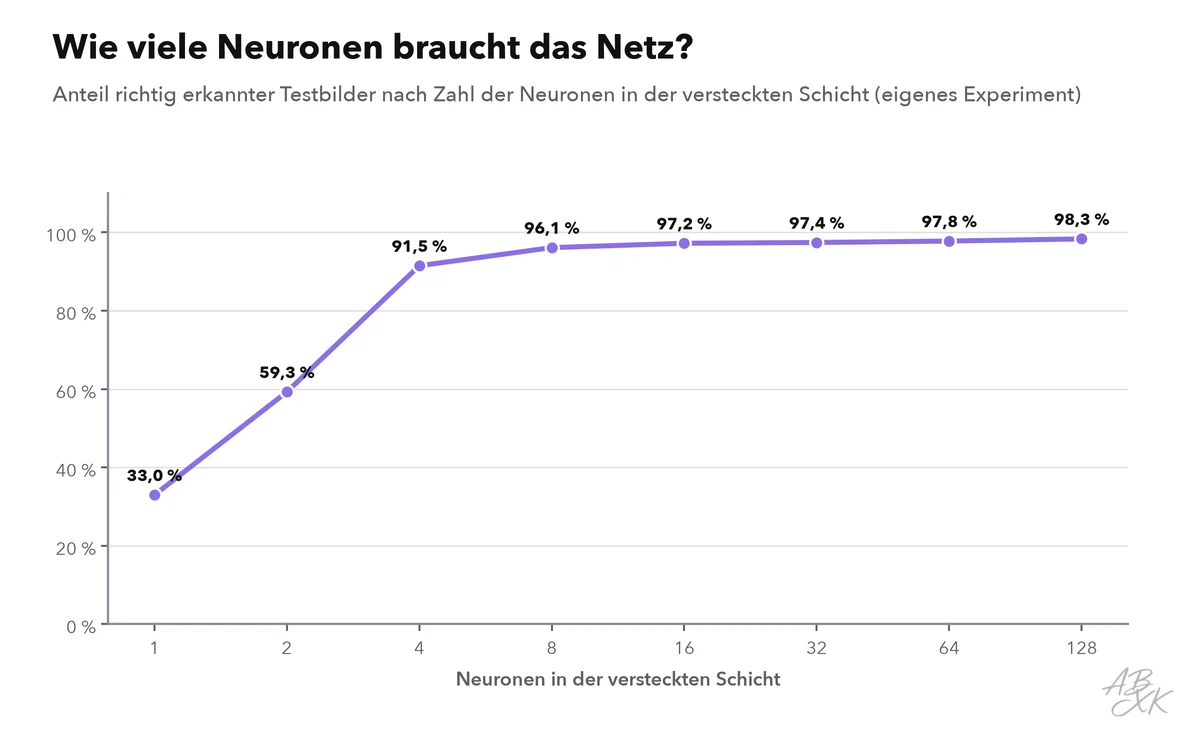
Mit einem einzigen versteckten Neuron erkannte das Netz nur 33 % der Ziffern: Alles, was es wusste, musste durch eine einzige Zahl. Mit 8 Neuronen erreichte es bereits 96,1 %, mit 64 Neuronen 97,8 %. Danach halfen mehr Neuronen kaum noch. Die Lehre gilt auch für große Modelle: Die Größe zählt viel, bis ein Netz groß genug für seine Aufgabe und seine Daten ist; darüber hinaus brauchen Sie mehr oder bessere Daten, nicht nur mehr Neuronen.
| Neuronen in der versteckten Schicht | Gewichte und Schwellen | Richtig erkannte Testbilder |
|---|---|---|
| 1 | 85 | 33,0 % |
| 2 | 160 | 59,3 % |
| 4 | 310 | 91,5 % |
| 8 | 610 | 96,1 % |
| 16 | 1.210 | 97,2 % |
| 32 | 2.410 | 97,4 % |
| 64 | 4.810 | 97,8 % |
| 128 | 9.610 | 98,3 % |
Eigenes Experiment: Datensatz Optical Recognition of Handwritten Digits (E. Alpaydin, C. Kaynak, UCI Machine Learning Repository, Lizenz CC BY 4.0), 1797 Bilder je 8 × 8 Pixel, davon 540 zum Testen zurückgehalten; scikit-learn 1.9.1, fester Zufallsstartwert — jeder Lauf ergibt dieselben Zahlen.
Ein Blick in unser Netz
Jedes versteckte Neuron hat ein Gewicht je Pixel, seine 64 Gewichte lassen sich also als 8 × 8 Bild zeichnen. Das haben wir für eine Version unseres Netzes mit 16 versteckten Neuronen getan, die 97,2 % der Testziffern erkannte. Violette Pixel treiben ein Neuron an, grüne bremsen es.
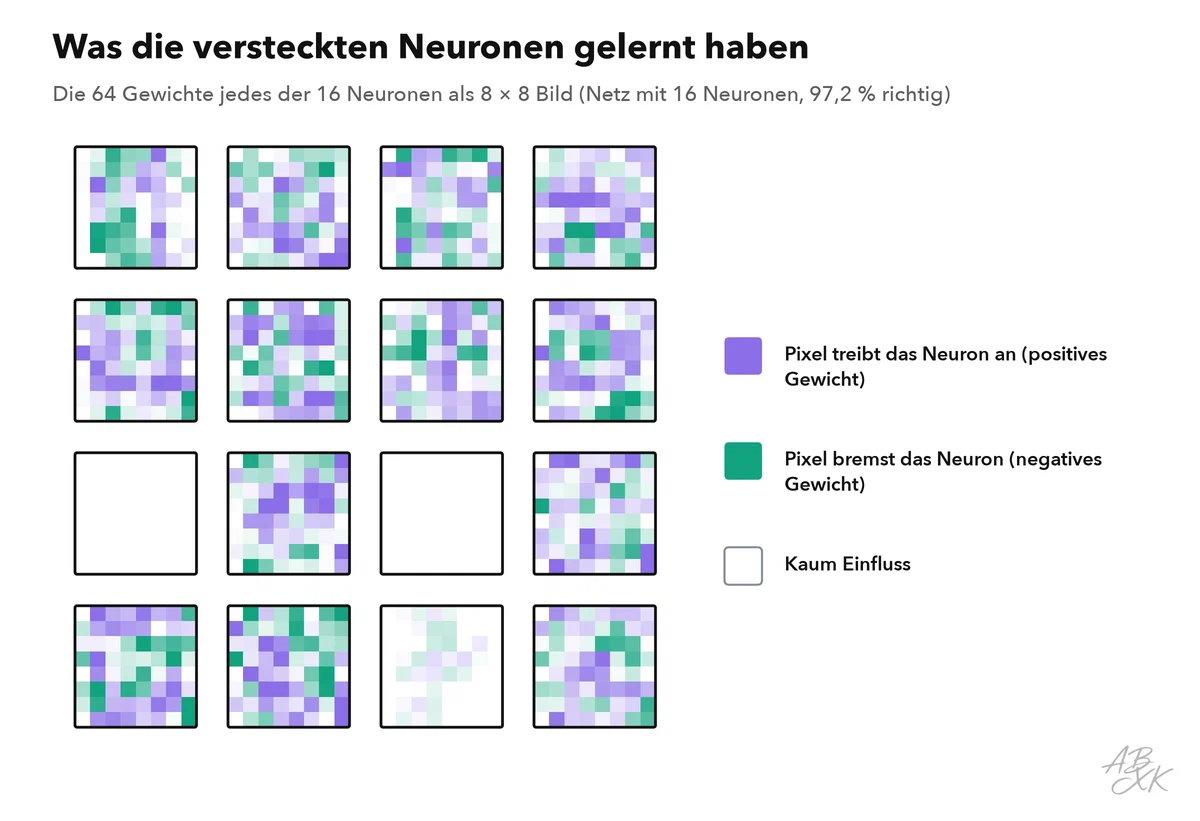
Die Bilder zeigen zwei Dinge, die für neuronale Netze typisch sind. Erstens sieht kein Neuron wie eine saubere Ziffer aus. Jedes reagiert auf eine verschwommene Mischung von Strichen, etwa Tinte in der Mitte und keine am Rand, und erst das Zusammenspiel vieler Neuronen erkennt eine Ziffer. Zweitens blieben zwei der 16 Neuronen völlig leer und eines fast: Ihre Gewichte landeten nahe null, sie feuern also nie und tragen nichts bei. Solche ungenutzten oder „toten“ Neuronen sind häufig — ein Grund, warum Netze oft größer gebaut werden, als sie eigentlich sein müssten.
Warum das für große Modelle zählt
Ein großes Sprachmodell ist im Kern dasselbe in gigantischem Maßstab: Eingaben werden zu Zahlen, viele Schichten von Neuronen, Milliarden im Training angepasste Gewichte und eine Ausgabeschicht, die das nächste Wortstück wählt. Was es stark macht, ist die Bauweise seiner Schichten, der Transformer, und die Menge an Daten und Rechenleistung dahinter — Themen von Level 3 und Level 4 dieses Lernpfads.
Level 1 dieses Lernpfads widmet sich dem klassischen maschinellen Lernen: Regression, Klassifikation, Clustering und woran Sie erkennen, ob ein Modell etwas taugt.