

„Das Modell lernt aus Daten“ ist schnell gesagt. Was heißt das in der Praxis? Wie viele Beispiele braucht ein Modell, was passiert, wenn ihm niemand die richtigen Antworten sagt, und wie lernt eine Maschine durch Versuch und Irrtum? Statt Lehrbuchbehauptungen zu wiederholen, haben wir die Experimente selbst durchgeführt — mit einem öffentlichen Datensatz, den jeder nutzen kann, und mit Code, der bei jedem Lauf dieselben Zahlen liefert.
Dies ist Teil 2 von Level 0 in unserem Lernpfad KI-Grundlagen. Sie lernen die drei Arten kennen, wie Maschinen lernen — überwacht, unüberwacht und bestärkend — und sehen, was jede davon in unserem Experiment erreicht hat. Code müssen Sie dafür nicht ausführen.
Das Experiment
Die Daten sind ein Klassiker des maschinellen Lernens: 1.797 Bilder handgeschriebener Ziffern von 0 bis 9, gesammelt von Forschenden der Boğaziçi-Universität in Istanbul und veröffentlicht im UCI Machine Learning Repository. Jedes Bild hat nur 8 × 8 = 64 Pixel. Die Aufgabe ist also klein genug, um in Sekunden auf einem Laptop zu laufen, und groß genug, um die echten Effekte zu zeigen. Wir haben 540 Bilder zurückgehalten, die kein Modell beim Training sah, und jedes Ergebnis daran gemessen — denn ein Modell, das nur auf seinen Trainingsdaten gut ist, hat nichts Brauchbares gelernt.
| Art des Lernens | Was das Modell bekommt | Was es lernt | Unser Ergebnis |
|---|---|---|---|
| Überwacht | Bilder mit der richtigen Ziffer als Label | Die Ziffer eines neuen Bildes zu benennen | 96,7 % der Testbilder richtig |
| Unüberwacht | Dieselben Bilder ohne Labels | Gruppen ähnlicher Bilder | 79,4 % landen in einer Gruppe, die zu ihrer Ziffer passt |
| Bestärkend | Keine Beispiele, nur Belohnungen fürs Erreichen eines Ziels | Eine Strategie für eine Aufgabe | Schritte bis zum Ziel sanken von 68,3 auf 8,1 |
Überwachtes Lernen: Beispiele mit Antworten
Beim überwachten Lernen (Supervised Learning) kommt jedes Trainingsbeispiel mit der richtigen Antwort, dem Label. Das Modell sieht ein Bild einer 7 zusammen mit dem Label „7“, tausendfach für alle Ziffern, und passt seine inneren Zahlen an, bis es die Labels gut vorhersagt. Wir haben die logistische Regression genutzt, eines der einfachsten Verfahren, und sie immer wieder mit mehr Beispielen trainiert.
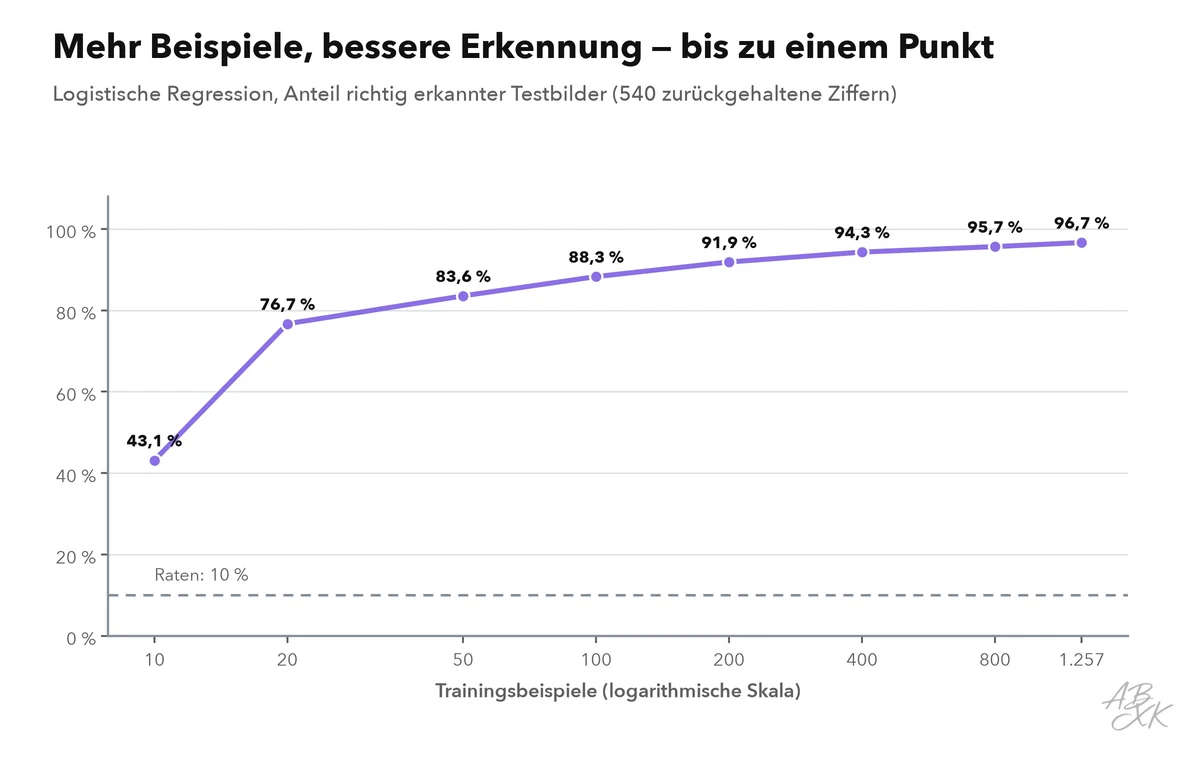
Mit nur 10 Beispielen erkannte das Modell 43,1 % der Testbilder: weit besser als Raten, das eine von zehn Ziffern träfe, aber in der Praxis unbrauchbar. Mit 100 Beispielen erreichte es 88,3 %, mit allen 1.257 Trainingsbildern 96,7 %. Die Kurve zeigt eine Regel, die weit über Ziffern hinaus gilt: Die ersten Beispiele bringen den größten Gewinn, und jeder weitere Schritt kostet mehr Daten für weniger Verbesserung. Deshalb ist das Sammeln der ersten paar Hundert guten Labels meist die wertvollste Investition in einem Projekt mit maschinellem Lernen.
| Trainingsbeispiele | Richtig erkannte Testbilder |
|---|---|
| 10 | 43,2 % |
| 20 | 76,7 % |
| 50 | 83,6 % |
| 100 | 88,3 % |
| 200 | 91,9 % |
| 400 | 94,3 % |
| 800 | 95,7 % |
| 1.257 | 96,7 % |
Eigenes Experiment: Datensatz Optical Recognition of Handwritten Digits (E. Alpaydin, C. Kaynak, UCI Machine Learning Repository, Lizenz CC BY 4.0), 1797 Bilder je 8 × 8 Pixel, davon 540 zum Testen zurückgehalten; scikit-learn 1.9.1, fester Zufallsstartwert — jeder Lauf ergibt dieselben Zahlen.
Unüberwachtes Lernen: Gruppen finden ohne Antworten
Beim unüberwachten Lernen (Unsupervised Learning) bekommt das Modell gar keine Labels. Es muss Strukturen selbst finden. Wir haben dieselben Bilder ohne die Ziffern an k-Means gegeben, ein Verfahren, das Daten in eine feste Zahl von Gruppen ähnlicher Elemente sortiert, und zehn Gruppen verlangt.
k-Means hat nie gelernt, was eine „7“ ist. Trotzdem passten die gefundenen Gruppen erstaunlich gut zu den Ziffern: Beschriftet man jede Gruppe mit der Ziffer, die darin am häufigsten vorkommt, landen 79,4 % aller Bilder in der richtigen Gruppe, und alle 10 Ziffern bekommen eine eigene Gruppe. Das Verfahren hat herausgefunden, dass Bilder derselben Ziffer einander ähneln. Auch Daten ohne Labels enthalten also Strukturen. Im Unternehmen findet dieselbe Idee Kundensegmente oder ungewöhnliche Transaktionen — dort, wo es von vornherein keine Labels gibt.
Bestärkendes Lernen: Versuch, Irrtum und Belohnung
Beim bestärkenden Lernen (Reinforcement Learning) gibt es gar keine Beispiele. Ein Agent handelt in einer Umgebung, bekommt eine Belohnung, wenn er ein Ziel erreicht, und lernt aus Erfahrung, welche Handlungen sich lohnen. Wir haben ein kleines Labyrinth gebaut: ein Gitter aus 5 × 5 Feldern mit Wänden, Start in einer Ecke, Ziel in der gegenüberliegenden. Der Agent nutzte ein Verfahren namens Q-Learning, begann ohne jedes Wissen und bewegte sich zufällig.
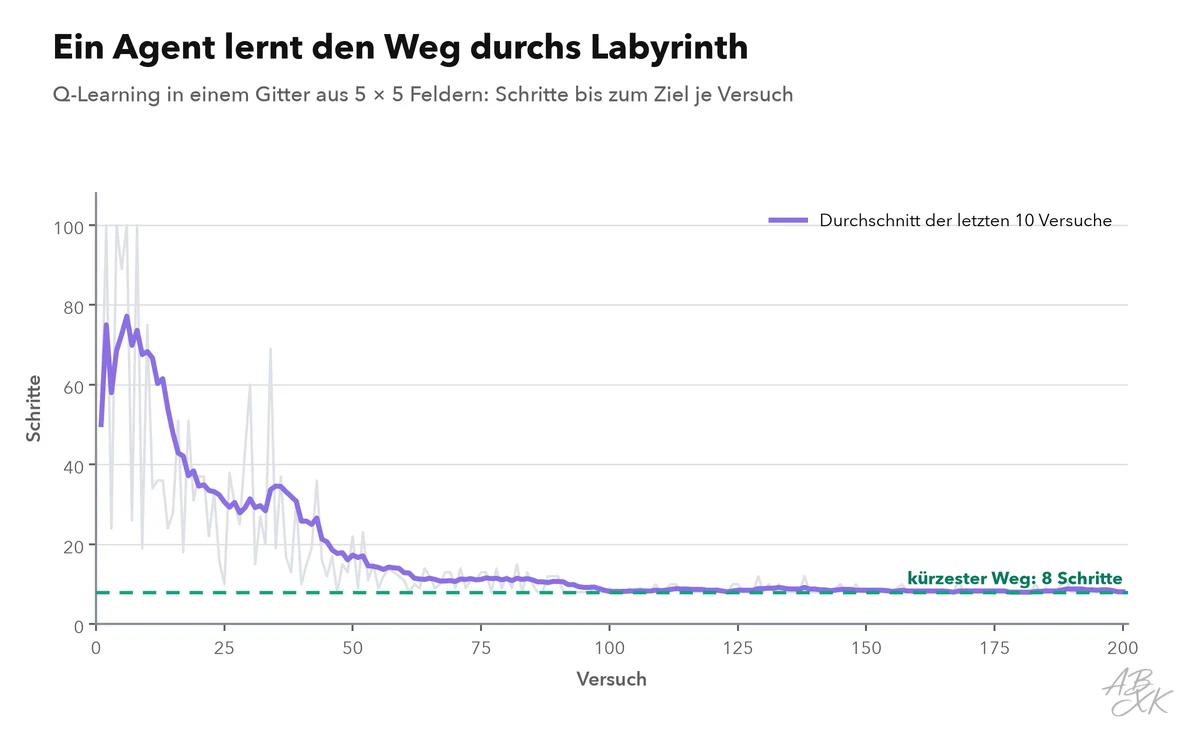
In seinen ersten zehn Versuchen brauchte der Agent im Schnitt 68,3 Schritte bis zum Ziel, in seinen letzten zehn 8,1 — nahe am kürzestmöglichen Weg von 8 Schritten. Niemand hat ihm den Weg gezeigt; die Belohnung allein genügte. Dasselbe Prinzip trainiert Spiel-KIs, Laufroboter und, in einer aufwendigeren Form namens Reinforcement Learning from Human Feedback, das Verhalten großer Sprachmodelle. Es funktioniert am besten dort, wo ein Agent oft und gefahrlos üben kann — deshalb sind Spiele und Simulationen sein natürliches Zuhause.
So haben wir das Experiment durchgeführt
Wir haben die Python-Bibliothek scikit-learn genutzt und die Kopie des Ziffern-Datensatzes, die ihr beiliegt. Für die Lernkurve haben wir Trainingsmengen verschiedener Größe je fünfmal aus den Trainingsbildern gezogen und geben den Durchschnitt an; alle Ergebnisse sind an denselben zurückgehaltenen Testbildern gemessen. k-Means lief ohne die Labels, die wir erst danach zur Prüfung der Gruppen genutzt haben. Der Labyrinth-Agent nutzte Q-Learning mit einer Belohnung von 1 fürs Erreichen des Ziels und einem kleinen Abzug für jeden Schritt, damit sich kürzere Wege lohnen. Alle Zufallsentscheidungen nutzen einen festen Startwert, die Zahlen auf dieser Seite fallen also bei jedem Lauf gleich aus; Datensatz, Testanteil und Startwert stehen zusätzlich unter jeder Tabelle. Der nächste Teil dieses Levels erklärt die zwei Phasen im Leben jedes KI-Modells: das Training, in dem es lernt, und die Inferenz, in der es antwortet. Eine breitere Einführung in Klassifikation und Modellfamilien bietet der Artikel So funktioniert maschinelles Lernen in unserem Lernpfad AI Development.