

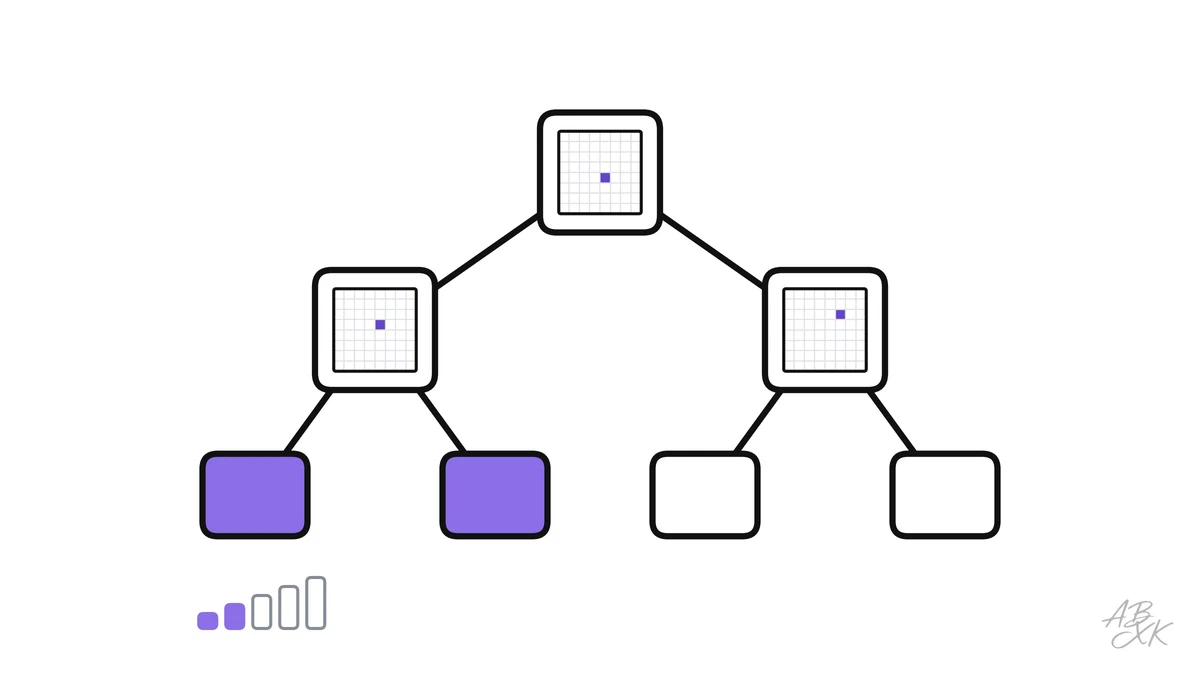
Ein Entscheidungsbaum funktioniert wie ein Ratespiel mit zwanzig Fragen. „Ist der Pixel in der Mitte dunkel? Wenn ja: Ist auch der Pixel oben links dunkel?“ Nach ein paar solchen Fragen kommt der Baum zu einer Antwort. Bäume sind in Unternehmen beliebt, weil jeder ihrer Logik folgen kann, und sie sind der Baustein einiger der erfolgreichsten Verfahren für Tabellendaten. Sie zeigen außerdem die wichtigste Falle des maschinellen Lernens deutlicher als jedes andere Modell: die Überanpassung (Overfitting).
Dies ist Teil 3 von Level 1 in unserem Lernpfad KI-Grundlagen. Sie erfahren, wie ein Baum seine Fragen findet, was geschah, als wir unsere Bäume auf den handgeschriebenen Ziffern aus Level 0 immer tiefer wachsen ließen, und wie ein Random Forest aus vielen Bäumen das Problem löst.
Wie ein Baum seine Fragen findet
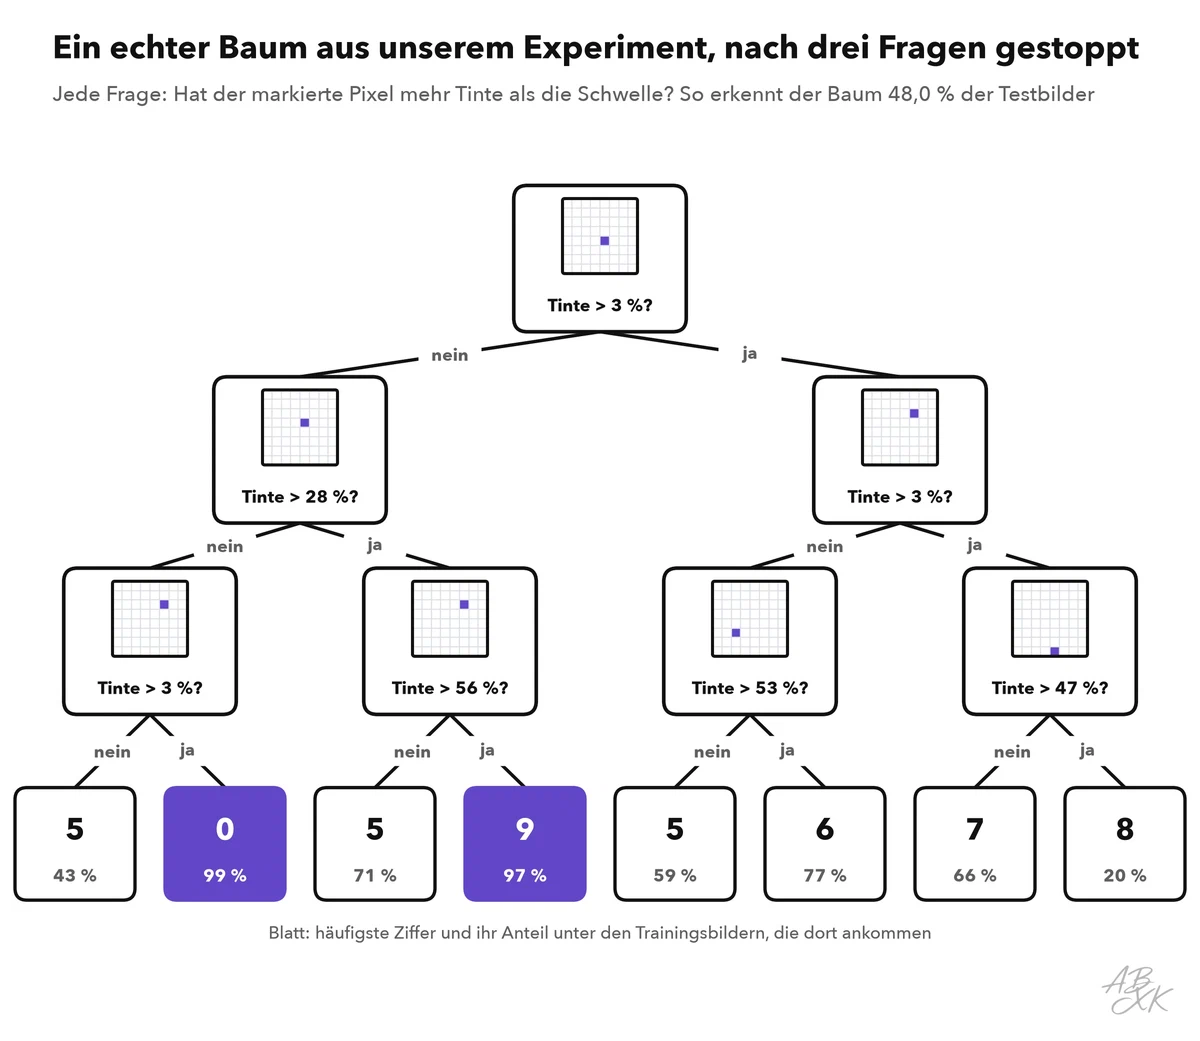
Beim Training prüft der Baum alle möglichen Fragen, für jeden Pixel und jeden Helligkeitswert, und wählt die, die die Ziffern am besten trennt: Nach der Aufteilung soll jede Gruppe möglichst wenige verschiedene Ziffern enthalten. Dann wiederholt er die Suche in jeder Gruppe, und so weiter. Jede Frage ist ein Knoten, jede letzte Gruppe ein Blatt, und die Zahl der Fragen von oben bis zu einem Blatt ist die Tiefe des Baums.
Die Abbildung zeigt die ersten drei Ebenen eines echten Baums aus unserem Experiment. Seine allererste Frage prüft einen Pixel in der Bildmitte: Hat er kaum Tinte, ist die Ziffer am wahrscheinlichsten eine 0, denn eine 0 ist in der Mitte offen. Nach drei Fragen erkennt dieser Baum 48 % der Testbilder. Die meisten seiner Blätter sind noch gemischt; um alle zehn Ziffern zu unterscheiden, braucht er viel mehr Fragen.
Von selbst hört der Baum nicht auf, solange ein Blatt noch gemischte Ziffern enthält. Lässt man ihn, fragt er weiter, bis jedes Trainingsbild in einem Blatt seiner Art liegt. In diesem Moment hört er auf, Muster zu lernen, und beginnt, Beispiele auswendig zu lernen.
Unser Experiment: tiefer ist nicht besser
Wir haben Bäume mit einer größten Tiefe von 1 bis 20 auf den Trainingsbildern trainiert und den Anteil richtiger Antworten zweimal gemessen: auf den Trainingsbildern selbst und auf den Testbildern, die der Baum nie gesehen hatte.
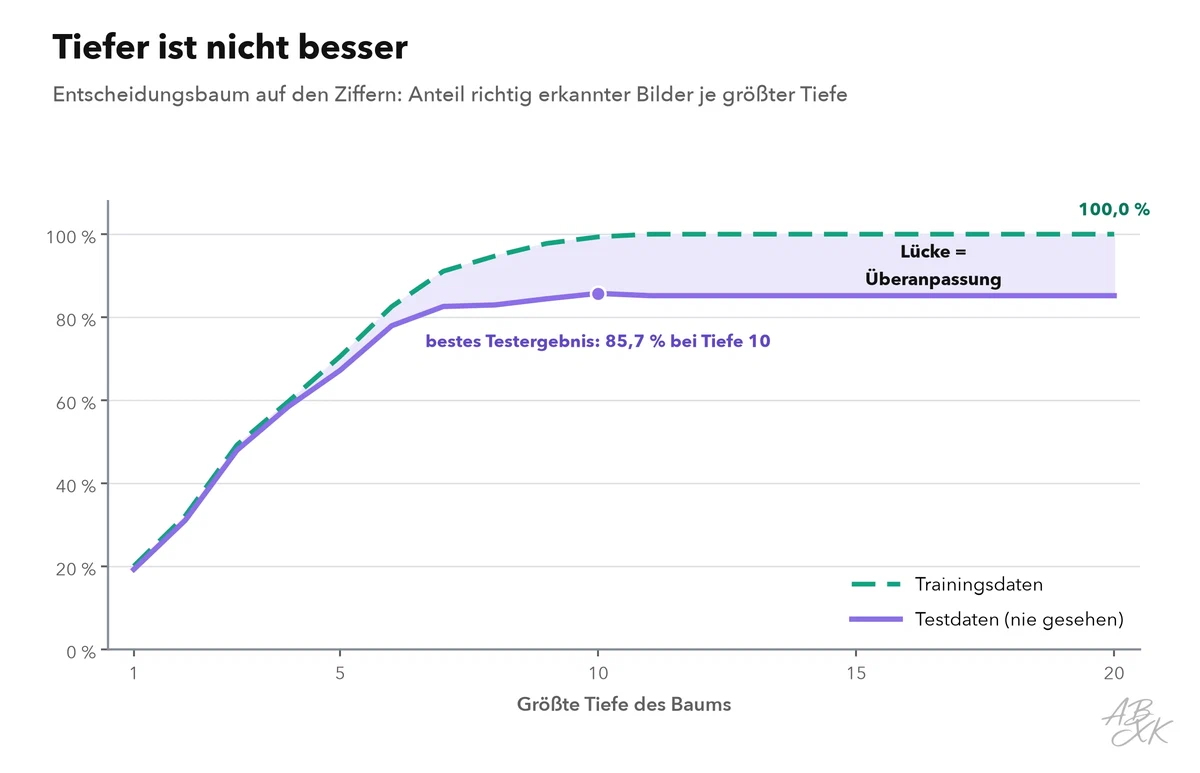
Das Ergebnis zeigt Überanpassung in Reinform. Mit genug Tiefe erkannte der Baum 100 % seiner Trainingsbilder: perfekt. Auf den Testbildern erreichte er nur 85,2 %. Das beste Testergebnis, 85,7 %, kam bei einer Tiefe von 10; jede weitere Frage half dem Baum nur noch, sich einzelne Trainingsbilder samt ihren Eigenheiten und ihrem Rauschen zu merken.
| Tiefe des Baums | Trainingsdaten | Testdaten |
|---|---|---|
| 1 | 20,1 % | 19,3 % |
| 2 | 32,2 % | 31,1 % |
| 3 | 49,2 % | 48,0 % |
| 5 | 70,6 % | 67,2 % |
| 8 | 94,8 % | 83,0 % |
| 10 | 99,4 % | 85,7 % |
| 15 | 100,0 % | 85,2 % |
| 20 | 100,0 % | 85,2 % |
Eigenes Experiment: Datensatz Optical Recognition of Handwritten Digits (E. Alpaydin, C. Kaynak, UCI Machine Learning Repository, Lizenz CC BY 4.0), 1797 Bilder je 8 × 8 Pixel, davon 540 zum Testen zurückgehalten; scikit-learn 1.9.1, fester Zufallsstartwert — jeder Lauf ergibt dieselben Zahlen.
Deshalb ist die Lücke zwischen Trainings- und Testergebnis das Erste, was Sie in jedem Projekt mit maschinellem Lernen prüfen sollten. Ein Modell, das auf seinen Trainingsdaten viel besser ist als auf neuen Daten, hat seine Beispiele gelernt, nicht die Aufgabe. Auch das umgekehrte Problem gibt es: Unsere flachsten Bäume schnitten auf beiden Arten von Daten schwach ab, weil wenige Fragen schlicht nicht reichen, um zehn Ziffern zu unterscheiden. Das heißt Unteranpassung (Underfitting).
| Ergebnis Training | Ergebnis Test | Befund | Was meist hilft |
|---|---|---|---|
| Niedrig | Niedrig | Unteranpassung: Das Modell ist zu einfach | Ein flexibleres Modell, bessere Merkmale, längeres Training |
| Hoch | Deutlich niedriger | Überanpassung: Das Modell hat seine Beispiele auswendig gelernt | Komplexität begrenzen, mehr Daten, Modelle kombinieren |
| Hoch | Nah am Training | Gute Anpassung | Vor dem Einsatz an frischen Daten bestätigen |
Die Lösung: viele Bäume statt einem
Ein Random Forest trainiert viele Bäume, jeden auf einer etwas anderen Zufallsauswahl der Trainingsdaten und mit einer zufälligen Teilmenge der Merkmale, aus denen er bei jeder Frage wählen darf. Jeder Baum passt sich auf seine Weise über, doch ihre Fehler unterscheiden sich — wenn die Bäume abstimmen, heben sich viele Fehler auf. Unser Wald aus 200 Bäumen erkannte 96,5 % der Testbilder, verglichen mit 85,2 % für einen einzelnen Baum ohne Grenzen.
| Verfahren | Richtig erkannte Testbilder |
|---|---|
| Logistische Regression | 96,7 % |
| k-nächste Nachbarn (k = 3) | 98,7 % |
| Entscheidungsbaum | 85,2 % |
| Random Forest (200 Bäume) | 96,5 % |
| Support Vector Machine | 98,3 % |
| Neuronales Netz (64 Neuronen) | 97,8 % |
Quelle wie bei der ersten Tabelle dieser Seite.
Der einzelne Baum ist das schwächste Verfahren dieser Tabelle, der Wald aus derselben Art von Bäumen gehört zu den stärksten. Dieselbe Idee, viele schwache Modelle zu kombinieren, heißt Ensemble, und ein verwandtes Verfahren namens Gradient Boosting, das jeden neuen Baum darauf trainiert, die Fehler der vorigen zu beheben, gehört zu den erfolgreichsten Verfahren für Geschäftsdaten in Tabellen.
So vermeiden Sie Überanpassung
- Immer mit zurückgehaltenen Daten testen. Beurteilen Sie ein Modell nie allein nach seinen Trainingsergebnissen.
- Die Komplexität begrenzen. Bei Bäumen eine größte Tiefe oder eine Mindestzahl an Beispielen je Blatt, bei anderen Modellen vergleichbare Einstellungen.
- Mehr Daten nutzen. Je mehr Beispiele, desto schwerer lassen sich alle auswendig lernen.
- Modelle kombinieren. Ensembles wie Random Forests verringern die Schwankung einzelner Modelle.
- Eine letzte Testmenge unberührt lassen. Wer seine Einstellungen viele Male an den Testdaten ausrichtet, passt sich auch an die Testdaten über.
Der nächste Teil vergleicht sechs klassische Verfahren auf denselben Daten und erklärt die Kreuzvalidierung, den üblichen Weg, Modelle fair zu vergleichen.