

Maschinelles Lernen bietet Dutzende Verfahren für dieselbe Aufgabe, und jedes hat seine Anhänger. Welches ist das beste? Die ehrliche Antwort lautet: Es hängt von den Daten ab, und das zeigt nur ein Test. Fair zu testen ist allerdings schwerer, als es aussieht, denn ein einzelner Test kann ein Verfahren zufällig besser oder schlechter aussehen lassen, als es ist.
Dies ist Teil 4 von Level 1 in unserem Lernpfad KI-Grundlagen. Wir haben sechs klassische Verfahren auf denselben handgeschriebenen Ziffern laufen lassen und mit Kreuzvalidierung verglichen, dem üblichen Weg, fair zu testen. Sie erfahren, was jedes Verfahren in einem Satz tut, wie Kreuzvalidierung funktioniert, welches Verfahren auf unseren Daten gewann und warum es deshalb nicht allgemein das beste ist.
Sechs Verfahren in je einem Satz
| Verfahren | Wie es entscheidet | Stärke | Schwäche |
|---|---|---|---|
| Logistische Regression | Gewichtet jeden Pixel und zählt die Hinweise für jede Ziffer zusammen | Schnell, leicht zu prüfen | Nur gerade Grenzen zwischen Kategorien |
| k-nächste Nachbarn | Sucht die ähnlichsten Trainingsbilder und lässt sie abstimmen | Gar kein Training, stark, wenn ähnlich gleich bedeutet | Langsam bei großen Daten, braucht ein gutes Ähnlichkeitsmaß |
| Entscheidungsbaum | Stellt eine Folge von Ja-Nein-Fragen zu Pixeln | Leicht zu erklären | Passt sich schnell über |
| Random Forest | Lässt Hunderte leicht verschiedene Bäume abstimmen | Robust, wenig Feinabstimmung nötig | Schwerer zu erklären als ein Baum |
| Support Vector Machine | Zieht die breitestmögliche Grenze zwischen Kategorien | Stark bei mittelgroßen Daten | Langsam bei großen Daten, viele Einstellungen |
| Neuronales Netz | Lernt eigene Merkmale in einer versteckten Schicht | Am flexibelsten | Braucht mehr Daten und Feinabstimmung |
Kreuzvalidierung: fünf Tests statt einem
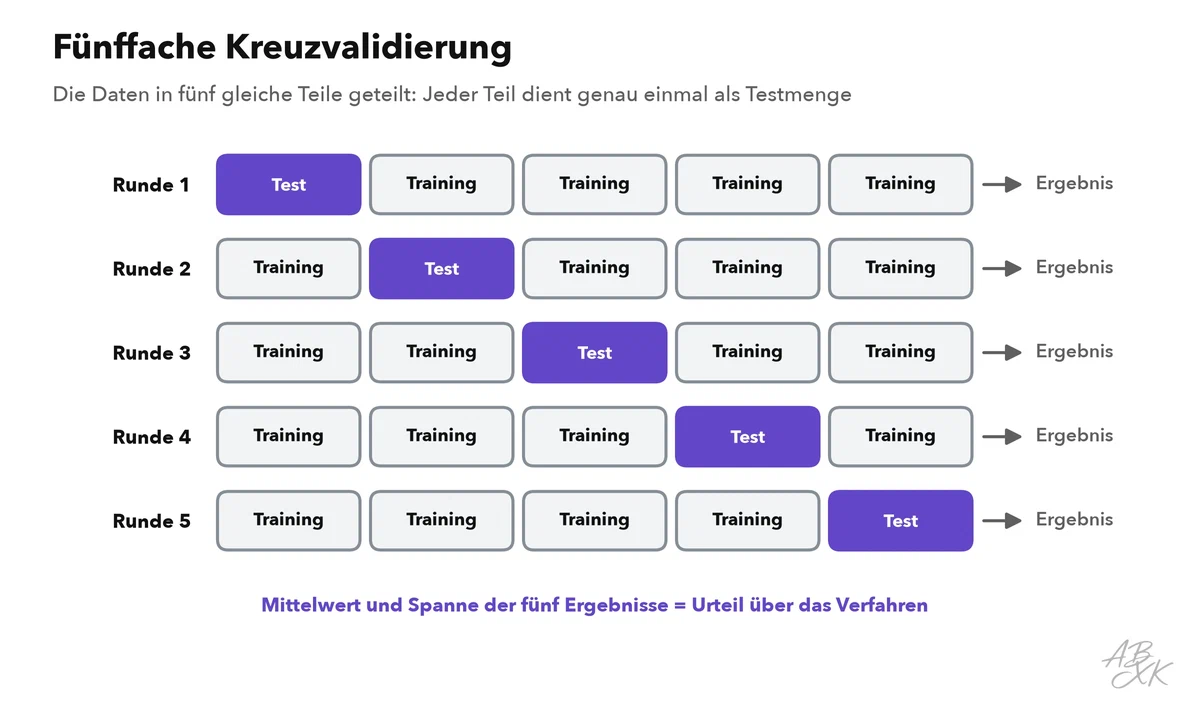
Eine einzelne Aufteilung in Trainings- und Testdaten ist ein bisschen wie eine einzelne Prüfung: Das Ergebnis hängt auch davon ab, welche Fragen zufällig drankamen. Die Kreuzvalidierung wiederholt den Test. Bei fünffacher Kreuzvalidierung werden die Daten in fünf gleiche Teile geteilt. Jedes Verfahren wird fünfmal trainiert, jeweils auf vier Teilen, und am fünften getestet, sodass jedes Bild genau einmal zum Testen dient. Heraus kommen ein Mittelwert und eine Spanne — sie zeigt, wie stabil ein Verfahren ist.
Das Ergebnis auf unseren Daten
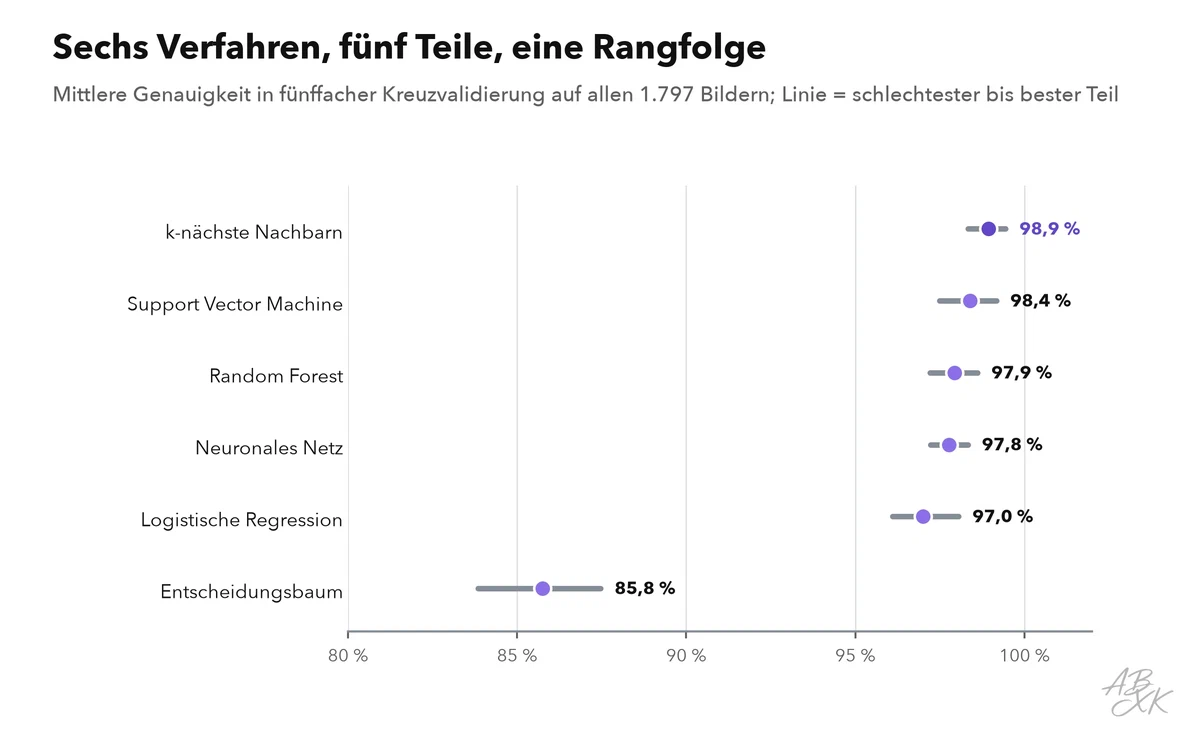
Auf den handgeschriebenen Ziffern gewann k-nächste Nachbarn mit im Mittel 98,9 %, vor der Support Vector Machine, dem Random Forest und dem neuronalen Netz, die nah beieinanderlagen. Die logistische Regression erreichte 97 %. Der einzelne Entscheidungsbaum landete mit 85,8 % auf dem letzten Platz, und seine Ergebnisse schwankten zwischen den Teilen am stärksten, mit einer Standardabweichung von 1,6 Prozentpunkten.
| Verfahren | Mittel | Schlechtester Teil | Bester Teil |
|---|---|---|---|
| k-nächste Nachbarn (k = 3) | 98,9 % | 98,3 % | 99,4 % |
| Support Vector Machine | 98,4 % | 97,5 % | 99,2 % |
| Random Forest (200 Bäume) | 97,9 % | 97,2 % | 98,6 % |
| Neuronales Netz (64 Neuronen) | 97,8 % | 97,2 % | 98,3 % |
| Logistische Regression | 97,0 % | 96,1 % | 98,1 % |
| Entscheidungsbaum | 85,8 % | 83,8 % | 87,5 % |
Eigenes Experiment: Datensatz Optical Recognition of Handwritten Digits (E. Alpaydin, C. Kaynak, UCI Machine Learning Repository, Lizenz CC BY 4.0), 1797 Bilder je 8 × 8 Pixel, davon 540 zum Testen zurückgehalten; scikit-learn 1.9.1, fester Zufallsstartwert — jeder Lauf ergibt dieselben Zahlen.
Warum gewinnt hier das einfachste Verfahren? Weil sich auf diesen kleinen, zentrierten Bildern zwei handgeschriebene 3en tatsächlich Pixel für Pixel ähneln — „finde das ähnlichste bekannte Beispiel“ funktioniert deshalb sehr gut. Auf Daten, bei denen Ähnlichkeit weniger offensichtlich ist, etwa Kundendatensätzen mit Dutzenden Spalten in verschiedenen Einheiten, fällt k-nächste Nachbarn meist zurück, und Baum-Ensembles oder Gradient Boosting liegen vorn.
Genauigkeit ist nicht die ganze Rechnung
Zwei Verfahren mit fast gleicher Genauigkeit können sich im Betrieb um Größenordnungen unterscheiden. Wir haben für jedes trainierte Modell gezählt, was es im Speicher behalten muss und wie viel Arbeit es höchstens für jedes neue Bild leistet.
| Verfahren | Behält nach dem Training | Umfang | Arbeit je neuem Bild (höchstens) |
|---|---|---|---|
| Logistische Regression | Gewichte | 650 | 640 Multiplikationen |
| k-nächste Nachbarn (k = 3) | Alle Trainingsbilder | 1.257 Bilder, 80.448 Pixelwerte | Vergleich mit 1.257 Bildern (80.448 Pixelwerte) |
| Entscheidungsbaum | Fragen und Blätter | 241 Knoten | 11 Fragen |
| Random Forest (200 Bäume) | Fragen und Blätter aller Bäume | 61.848 Knoten | 2.653 Fragen |
| Support Vector Machine | Stützvektoren: Trainingsbilder nahe den Grenzen | 686 Bilder, 43.904 Pixelwerte | Vergleich mit 686 Bildern (43.904 Pixelwerte) |
| Neuronales Netz (64 Neuronen) | Gewichte und Schwellen | 4.810 | 4.736 Multiplikationen |
Quelle wie bei der ersten Tabelle dieser Seite.
Der Sieger bei der Genauigkeit ist im Betrieb am teuersten. k-nächste Nachbarn behält alle 1.257 Trainingsbilder, 80.448 Pixelwerte, und vergleicht jedes neue Bild mit jedem davon. Die logistische Regression kommt mit 650 Gewichten aus, rund 124-mal weniger Zahlen, und erreichte in der Kreuzvalidierung 97 % statt 98,9 %. Die Support Vector Machine behält nur die Trainingsbilder nahe den Grenzen zwischen den Ziffern, 686 Stück. Das neuronale Netz speichert 4.810 Gewichte, der Random Forest 61.848 Fragen und Blätter in seinen 200 Bäumen.
Bei kleinen Bildern wie unseren passt all das problemlos auf jedes Smartphone. Bei Millionen großer Bilder oder Dokumente entscheidet der Unterschied, ob ein Verfahren überhaupt laufen kann. Deshalb setzt k-nächste Nachbarn im Betrieb auf spezielle Suchindizes, die ähnliche Elemente finden, ohne jedes einzelne zu vergleichen — dieselbe Technik, auf der Vektordatenbanken aufbauen.
Es gibt kein bestes Verfahren
Die Forschung zum maschinellen Lernen hat für diese Beobachtung einen Namen: das No-Free-Lunch-Prinzip. Kein Verfahren ist für jede Art von Daten das beste. Deshalb folgen Fachleute ein paar Gewohnheiten:
- Mit einer einfachen Grundlinie beginnen, etwa der logistischen Regression. Jedes aufwendigere Verfahren muss sie klar schlagen.
- Mit Kreuzvalidierung vergleichen, nicht mit einer glücklichen Aufteilung, und neben dem Mittelwert auch auf die Spanne schauen.
- Mehr als die Genauigkeit zählen. Tempo, Speicher, Trainingskosten und ob Menschen die Entscheidungen nachvollziehen können, zählen im Betrieb.
- Bei knappen Ergebnissen das einfachere Modell nehmen. Ein Unterschied von wenigen Zehntelprozent liegt oft im Bereich des Zufalls.
- Auf den eigenen Daten testen. Benchmarks auf fremden Daten, auch unsere, sagen nur, was Sie zuerst ausprobieren sollten.
So haben wir das Experiment durchgeführt
Wir haben die Python-Bibliothek scikit-learn mit weitgehend üblichen Einstellungen genutzt: k-nächste Nachbarn mit k = 3, einen Random Forest mit 200 Bäumen, eine Support Vector Machine mit ihrem Standardkern auf standardisierten Pixelwerten und ein neuronales Netz mit einer versteckten Schicht aus 64 Neuronen. Die fünf Teile sind geschichtet, enthalten also jede Ziffer zu etwa gleichen Anteilen, und die Aufteilung nutzt einen festen Startwert — die Zahlen auf dieser Seite kommen bei jedem Lauf gleich heraus. Die Zahlen der Aufwandstabelle stammen von den Modellen, die auf den 1.257 Trainingsbildern trainiert wurden. Der letzte Teil von Level 1 widmet sich Daten ganz ohne Labels: Gruppen finden mit Clustering und Daten vereinfachen mit PCA.