

Die meisten Daten in einem Unternehmen haben keine Labels. Niemand hat markiert, welche Kunden zusammengehören, welche Messwerte einer Maschine normal sind oder welche Dokumente dasselbe Thema behandeln. Das unüberwachte Lernen arbeitet genau mit solchen Daten. Es lernt nicht, eine bekannte Antwort vorherzusagen, sondern sucht Struktur: Gruppen ähnlicher Dinge oder eine einfachere Art, die Daten zu beschreiben.
Dies ist Teil 5 von Level 1 in unserem Lernpfad KI-Grundlagen. Wir kehren zu den handgeschriebenen Ziffern zurück, verraten den Verfahren diesmal aber nicht, welche Ziffer ein Bild zeigt. Sie erfahren, wie k-Means-Clustering Gruppen findet, warum die schwierigste Frage lautet, nach wie vielen Gruppen man suchen soll, und wie die Hauptkomponentenanalyse (PCA) jedes Bild von 64 Zahlen auf eine Handvoll verdichtet — und was das mit den Gruppen macht.
Wie k-Means Gruppen findet
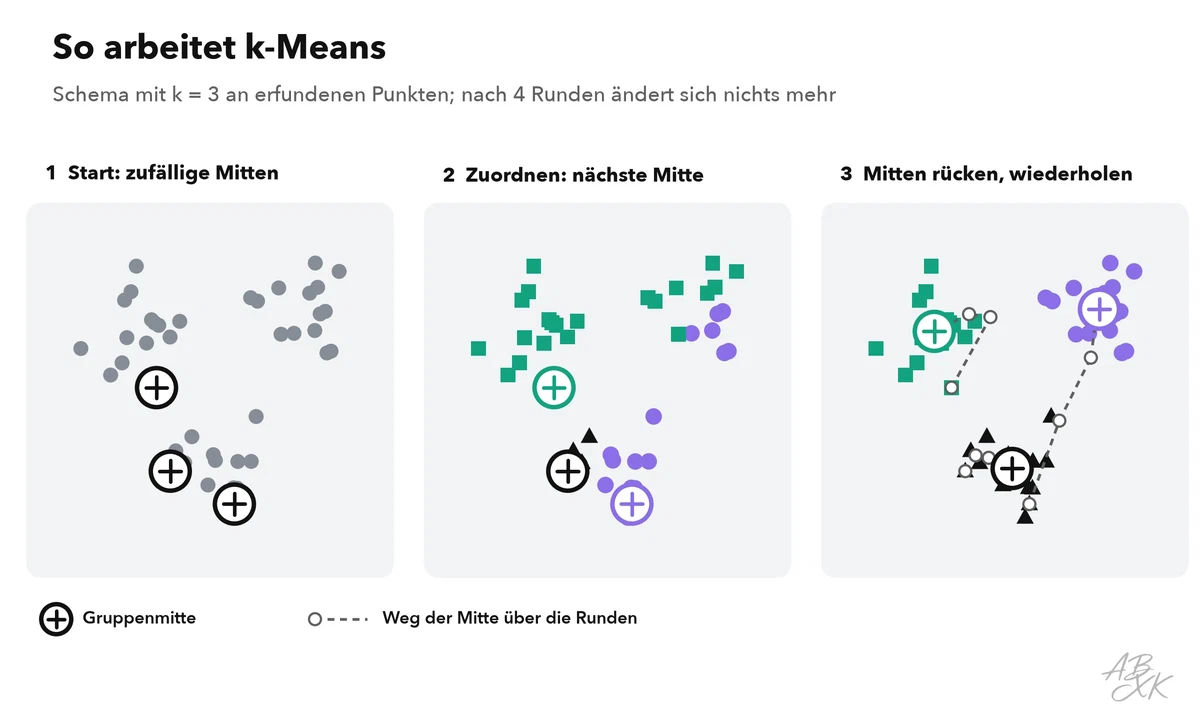
k-Means braucht von Ihnen eine Einstellung: die Zahl der Gruppen, genannt k. Dann wiederholt das Verfahren zwei einfache Schritte:
- Zuordnen. Jeder Datenpunkt kommt in die Gruppe mit der nächstgelegenen Mitte.
- Aktualisieren. Jede Gruppenmitte rückt in den Durchschnitt ihrer Mitglieder.
Zu Beginn werden die Mitten zufällig gesetzt. Nach einigen Runden ändern sich die Zuordnungen nicht mehr, und das Verfahren ist fertig. Weil das Ergebnis vom zufälligen Start abhängt, läuft es meist mehrmals, und der beste Lauf wird behalten. Wir haben zehn Läufe genutzt.
Unser Experiment: zehn Gruppen, keine Labels
Wir haben k-Means nach zehn Gruppen in den 1.797 Ziffernbildern suchen lassen, ohne Labels. Erst danach haben wir mit den Labels geprüft, was jede Gruppe enthält.
| Häufigste Ziffer in der Gruppe | Bilder in der Gruppe | Anteil dieser Ziffer | Nächsthäufige Ziffern (Bilder) |
|---|---|---|---|
| 0 | 179 | 98,9 % | 2 (1), 6 (1) |
| 4 | 168 | 98,8 % | 0 (1), 5 (1) |
| 6 | 182 | 97,3 % | 1 (2), 8 (2) |
| 5 | 157 | 87,3 % | 8 (6), 9 (6) |
| 7 | 198 | 85,9 % | 4 (8), 3 (7) |
| 3 | 181 | 85,6 % | 2 (13), 9 (6) |
| 2 | 176 | 84,1 % | 1 (24), 8 (3) |
| 1 | 89 | 61,8 % | 9 (20), 8 (6) |
| 9 | 241 | 57,7 % | 8 (48), 5 (41) |
| 8 | 226 | 45,1 % | 1 (99), 2 (8) |
Eigenes Experiment: Datensatz Optical Recognition of Handwritten Digits (E. Alpaydin, C. Kaynak, UCI Machine Learning Repository, Lizenz CC BY 4.0), 1797 Bilder je 8 × 8 Pixel, davon 540 zum Testen zurückgehalten; scikit-learn 1.9.1, fester Zufallsstartwert — jeder Lauf ergibt dieselben Zahlen.
Manche Gruppen sind fast rein. Die Gruppe, die vor allem Nullen enthält, besteht zu 98,9 % aus Nullen, denn eine Null sieht nach nichts anderem aus. Andere Gruppen sind gemischt: In der Gruppe, in der die 8 am häufigsten ist, sind nur 45,1 % der 226 Bilder wirklich 8en. Fast alle übrigen, 99 Bilder, sind 1en: Nach dem Abstandsmaß des Verfahrens liegen viele 1en näher an der durchschnittlichen 8 als an der durchschnittlichen 1. Die 1en verteilen sich auf mehrere Gruppen. Insgesamt landen 79,4 % der Bilder in der Gruppe ihrer eigenen Ziffer. Das ist beachtlich für ein Verfahren, das kein einziges Label gesehen hat — und zugleich eine Warnung: Gruppen, die ein Algorithmus findet, sind nach seinem Abstandsmaß ähnlich, nicht unbedingt nach der Bedeutung, die Ihnen wichtig ist.
Wie viele Gruppen? Die Verfahren sind uneins
Bei den Ziffern kennen wir die richtige Antwort: zehn. Bei echten Geschäftsdaten kennt sie niemand. Zwei verbreitete Verfahren sollen helfen.
Die Ellbogenmethode lässt k-Means für viele Werte von k laufen und trägt auf, wie weit die Punkte insgesamt von ihren Gruppenmitten entfernt sind. Mehr Gruppen verringern diesen Abstand immer, also sucht man den „Ellbogen“: den Punkt, ab dem sich weitere Gruppen nicht mehr lohnen. Der Silhouettenwert prüft für jeden Punkt, ob er seiner eigenen Gruppe deutlich näher ist als der nächsten; ein höherer Durchschnitt bedeutet sauberere Gruppen.
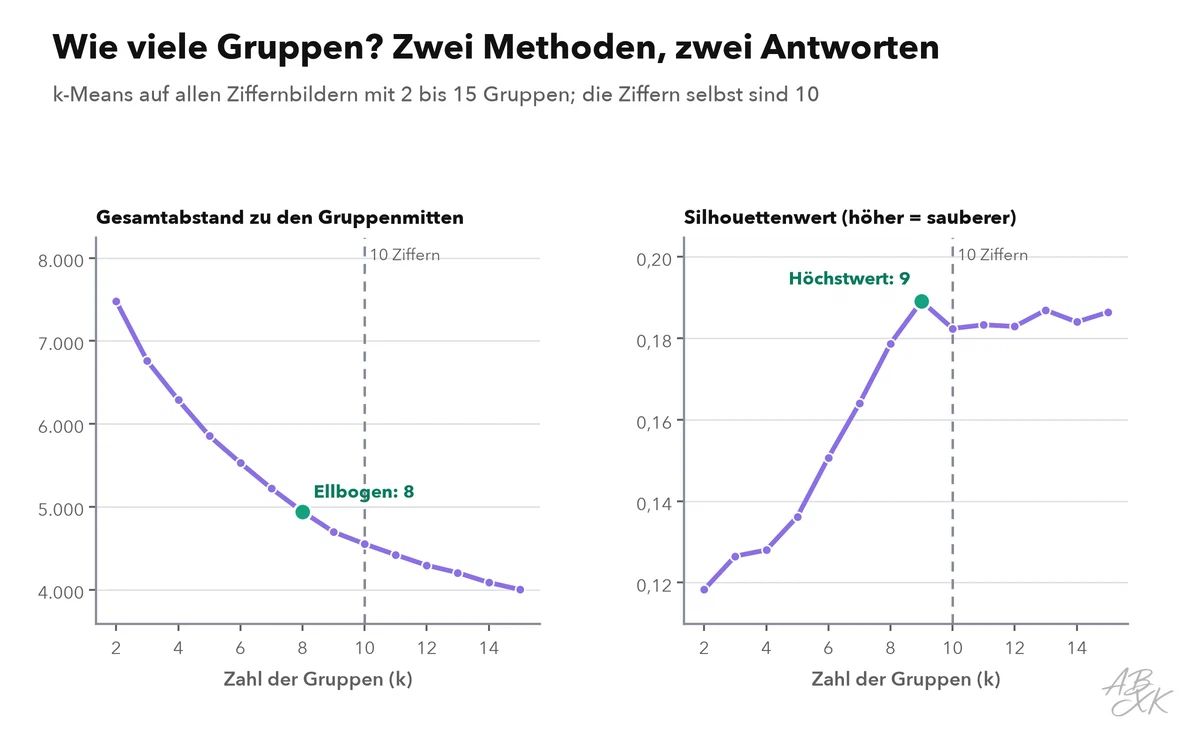
Auf unseren Daten zeigte die Ellbogenmethode auf 8 Gruppen, der Silhouettenwert auf 9. Keines der beiden fand die wahren zehn. Die Kurve knickt nur sanft, und der beste Silhouettenwert, 0,19 auf einer Skala von −1 bis 1, ist niedrig — die Gruppen überlappen also stark. Das ist typisch für echte Daten. Die Verfahren geben Ihnen einen Bereich zum Ausprobieren, doch die endgültige Zahl der Gruppen ist eine Entscheidung, die Sie danach treffen, wofür die Gruppen gedacht sind: Fünf Kundensegmente, mit denen ein Vertriebsteam arbeiten kann, können nützlicher sein als die zwölf, die etwas besser abschneiden.
PCA: dieselben Bilder in weniger Zahlen
Jedes Ziffernbild besteht aus 64 Zahlen, eine je Pixel. Doch die Pixel sind nicht unabhängig: Ist die Mitte einer 0 leer, sind ihre Nachbarn wahrscheinlich auch leer. Die Hauptkomponentenanalyse (PCA) nutzt das. Sie findet neue Richtungen in den Daten, die Hauptkomponenten, geordnet danach, wie viel der Unterschiede zwischen den Bildern sie erfassen. Die erste Richtung erfasst am meisten, die zweite am meisten vom Rest, und so weiter. Wer nur die ersten Richtungen behält, beschreibt jedes Bild mit weniger Zahlen und verliert dabei so wenig wie möglich.
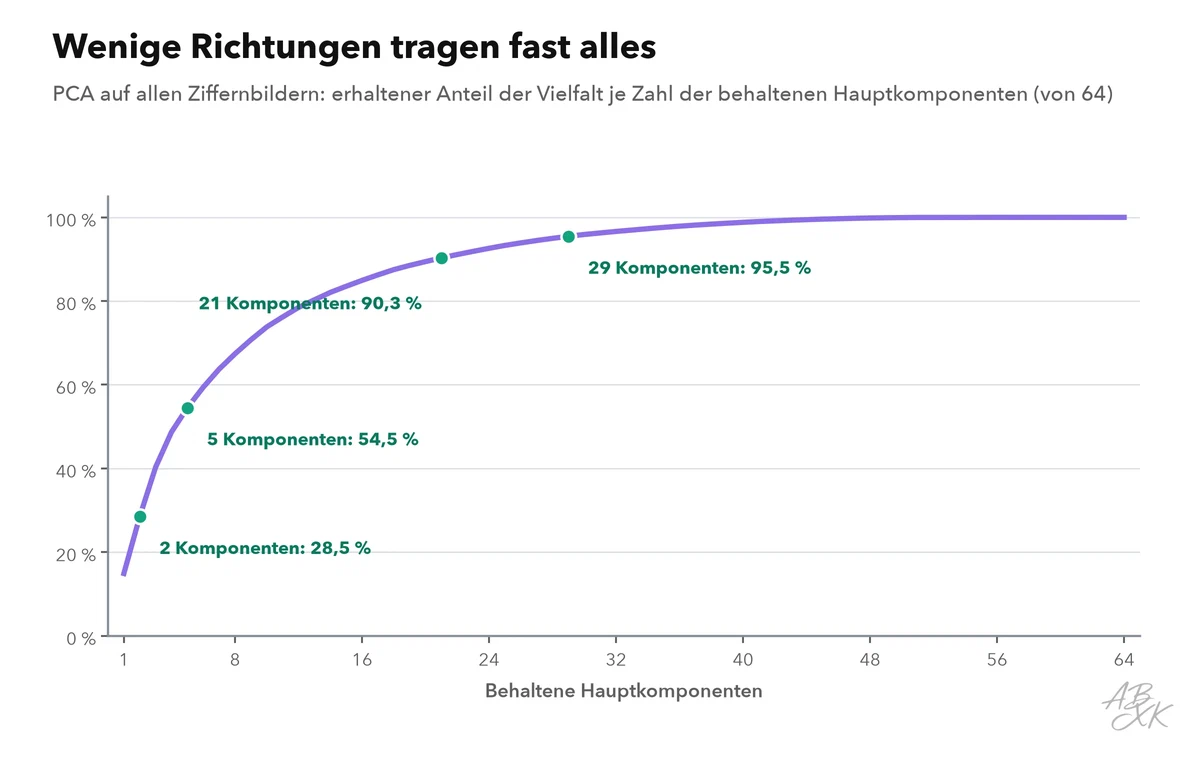
Die Kurve steigt zunächst steil. Schon 5 Richtungen erhalten 54,5 % der Vielfalt, 21 mehr als 90 % und 29 mehr als 95 %. Die letzten Richtungen tragen fast nichts bei: Jede von ihnen beschreibt einen einzelnen Pixel am linken oder rechten Bildrand, und diese Pixel sind fast immer leer.
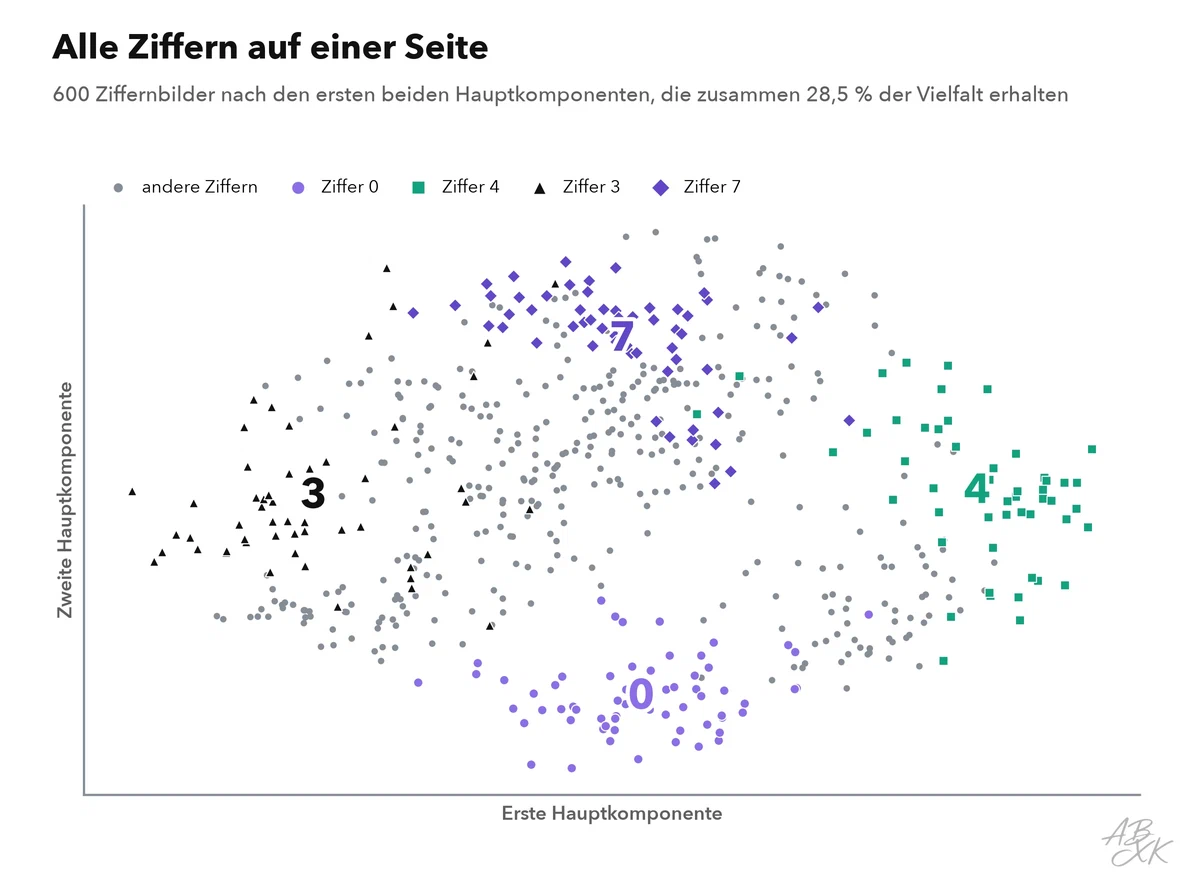
Die ersten beiden Richtungen allein erhalten nur 28,5 % der Vielfalt, reichen aber, um den ganzen Datensatz auf eine flache Seite zu zeichnen. Auf dieser Karte bilden manche Ziffern klare Inseln: Nullen unten, Vieren rechts, Dreien links und Siebenen oben. Andere überlappen in der Mitte, darunter die 1en, 8en und 9en — die Ziffern, die k-Means am stärksten vermischt hat.
Erst verdichten, dann gruppieren
Weniger Zahlen je Bild machen jeden weiteren Schritt schneller und günstiger. Leiden aber die Gruppen darunter? Wir haben k-Means noch einmal laufen lassen, nachdem wir die Bilder mit PCA verdichtet hatten.
| Behaltene Richtungen (von 64) | Erhaltene Vielfalt | k-Means: Bilder in der Gruppe ihrer Ziffer |
|---|---|---|
| 2 | 28,5 % | 59,4 % |
| 5 | 54,5 % | 71,7 % |
| 13 | 80,3 % | 78,7 % |
| 21 | 90,3 % | 79,6 % |
| 64 | 100,0 % | 79,4 % |
Quelle wie bei der ersten Tabelle dieser Seite.
Mit nur zwei Richtungen ordnete k-Means lediglich 59,4 % der Bilder der Gruppe ihrer Ziffer zu, weil zu viel Information verloren ging. Mit 21 Richtungen lag das Ergebnis bei 79,6 % — so gut wie mit allen 64 Pixeln (79,4 %), mit einem Drittel der Zahlen. Die Richtungen, die beim Verdichten wegfielen, trugen wenig, was für die Gruppen zählte. Deshalb sind PCA und verwandte Verfahren ein üblicher erster Schritt vor Clustering, Suche und Visualisierung. Die Embeddings, mit denen KI-Systeme Texte und Bilder vergleichen, folgen einer verwandten Idee: Sie beschreiben jedes Element mit einer Liste von Zahlen, in der ähnliche Elemente nah beieinanderliegen.
| Frage | Clustering | PCA |
|---|---|---|
| Was tut es? | Ordnet Ähnliches in Gruppen | Beschreibt Daten mit weniger Zahlen |
| Was wählen Sie? | Die Zahl der Gruppen | Die Zahl der behaltenen Richtungen |
| Typischer Einsatz | Kundensegmente, Dokumente gruppieren, ungewöhnliche Fälle erkennen | Diagramme komplexer Daten, schnelleres Training, Rauschen entfernen |
| Größtes Risiko | Gruppen, die nach Abstand ähnlich sind, aber nicht nach Bedeutung | Ein kleines, aber wichtiges Detail wegwerfen |
So haben wir das Experiment durchgeführt
Wir haben die Python-Bibliothek scikit-learn und die mitgelieferte Kopie des Ziffern-Datensatzes genutzt, mit allen 1.797 Bildern und Pixelwerten, skaliert auf 0 bis 1. k-Means lief für jede Zahl von Gruppen zehnmal von verschiedenen zufälligen Starts, der beste Lauf wurde behalten. Um den Ellbogen automatisch zu finden, haben wir den Punkt genommen, der am weitesten unter einer Geraden vom ersten zum letzten Punkt der Kurve liegt. Die Labels dienten nur dazu, die Gruppen zu bewerten, nie dazu, sie zu bilden. Alle Zufallsentscheidungen nutzen einen festen Startwert, sodass die Zahlen auf dieser Seite bei jedem Lauf gleich herauskommen. Level 2 dieses Lernpfads wendet sich dem Deep Learning zu: was sich ändert, wenn Netze viele Schichten bekommen.