

Spam oder nicht, Betrug oder normale Zahlung, welche Abteilung soll dieses Ticket bekommen: Die meisten Entscheidungen, die Unternehmen dem maschinellen Lernen übergeben, sind Klassifikationen, also eine Wahl zwischen wenigen festen Kategorien. Ein Klassifikator ist schnell gebaut. Zu wissen, ob er gut ist, ist schwerer — denn eine einzelne Zahl wie „96 % richtig“ kann genau die Fehler verbergen, auf die es ankommt.
Dies ist Teil 2 von Level 1 in unserem Lernpfad KI-Grundlagen. Wir nehmen die Ziffernerkennung aus Level 0, eine logistische Regression, trainiert auf handgeschriebenen Ziffern, und betrachten ihre Ergebnisse so, wie es Fachleute tun: mit Genauigkeit, Konfusionsmatrix, Precision und Recall — und der Schwelle, die zwischen beiden entscheidet.
Die Genauigkeit und was sie verschweigt
Die Genauigkeit (Accuracy) ist der Anteil richtiger Antworten. Unser Klassifikator erkannte 96,7 % der 540 Testbilder, also 18 Fehler. Das klingt gut, und für Ziffern ist es das auch. Doch die Genauigkeit behandelt alle Fehler gleich, und sie kann täuschen, wenn die Kategorien ungleich verteilt sind. Ist nur jede hundertste Zahlung Betrug, erreicht ein „Klassifikator“, der jede Zahlung für normal erklärt, 99 % Genauigkeit — und findet keinen einzigen Betrug. Bevor Sie einer Genauigkeit trauen, fragen Sie, wie oft jede Kategorie vorkommt und welche Fehler teuer sind.
Die Konfusionsmatrix: welche Fehler passieren
Eine Konfusionsmatrix zählt für jede wahre Kategorie, was das Modell vorhergesagt hat. Richtige Antworten stehen auf der Diagonale; jede Zelle daneben ist eine bestimmte Art von Fehler.
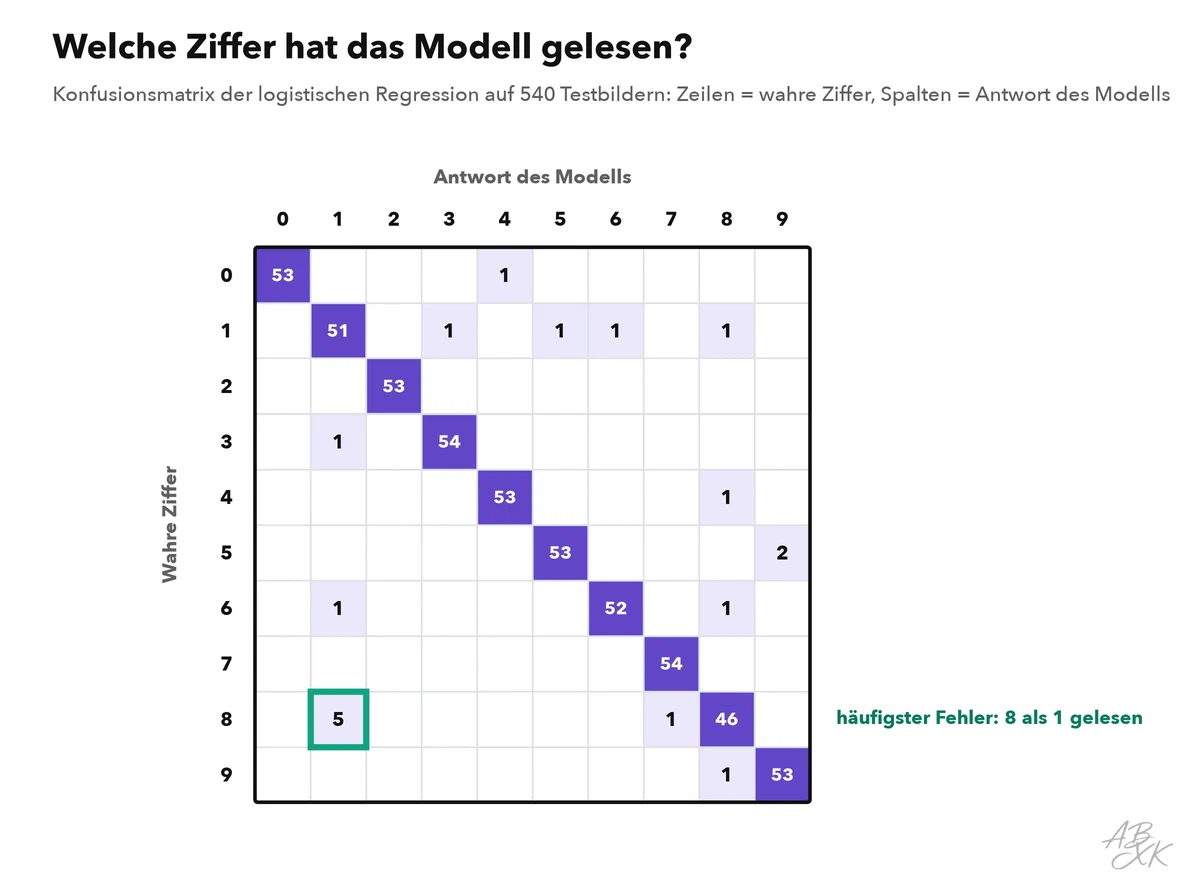
Die Matrix zeigt, was die Genauigkeit verschweigt: Die Fehler sind nicht gleichmäßig verteilt. Der häufigste Fehler war eine 8, die als 1 gelesen wurde, 5-mal. Am schwersten fiel dem Modell die 8: Es erkannte nur 88,5 % davon. In einem echten Projekt würden Sie hier weitersuchen: bei den schwierigen Beispielen, ob mehr Trainingsdaten für diese Kategorie helfen oder ob die Eingabe selbst — hier ein winziges Bild aus 8 × 8 Pixeln — die Details verliert, die die Kategorien unterscheiden.
Precision und Recall
Für eine einzelne Kategorie zählen zwei Fragen, und sie ziehen in entgegengesetzte Richtungen:
- Precision: Von allem, was das Modell als „9“ markiert hat — wie viel war wirklich eine 9? Geringe Precision heißt viele Fehlalarme.
- Recall: Von allen echten 9en — wie viele hat das Modell gefunden? Geringer Recall heißt viele Übersehene.
| Das Modell sagt „9“ | Das Modell sagt „keine 9“ | |
|---|---|---|
| Es ist wirklich eine 9 | Treffer (richtig positiv) | Übersehen (falsch negativ) |
| Es ist keine 9 | Fehlalarm (falsch positiv) | Richtig abgelehnt (richtig negativ) |
Die Precision zählt die Treffer unter allen Alarmen, der Recall die Treffer unter allen echten 9en. Ein Spamfilter braucht hohe Precision, weil eine echte E-Mail im Spam-Ordner teuer ist. Eine Betrugsprüfung oder ein medizinischer Suchtest braucht hohen Recall, weil ein übersehener Fall teuer ist. Was wichtiger ist, ist keine technische Frage, sondern eine geschäftliche Entscheidung.
Die Schwelle entscheidet
Ein Klassifikator sagt nicht nur „9“ oder „keine 9“. Er gibt eine Wahrscheinlichkeit aus, und Sie legen die Schwelle fest, ab der sie als 9 zählt. Wir haben diese Schwelle für unser Modell verändert und die Ergebnisse auf den Testbildern gezählt.
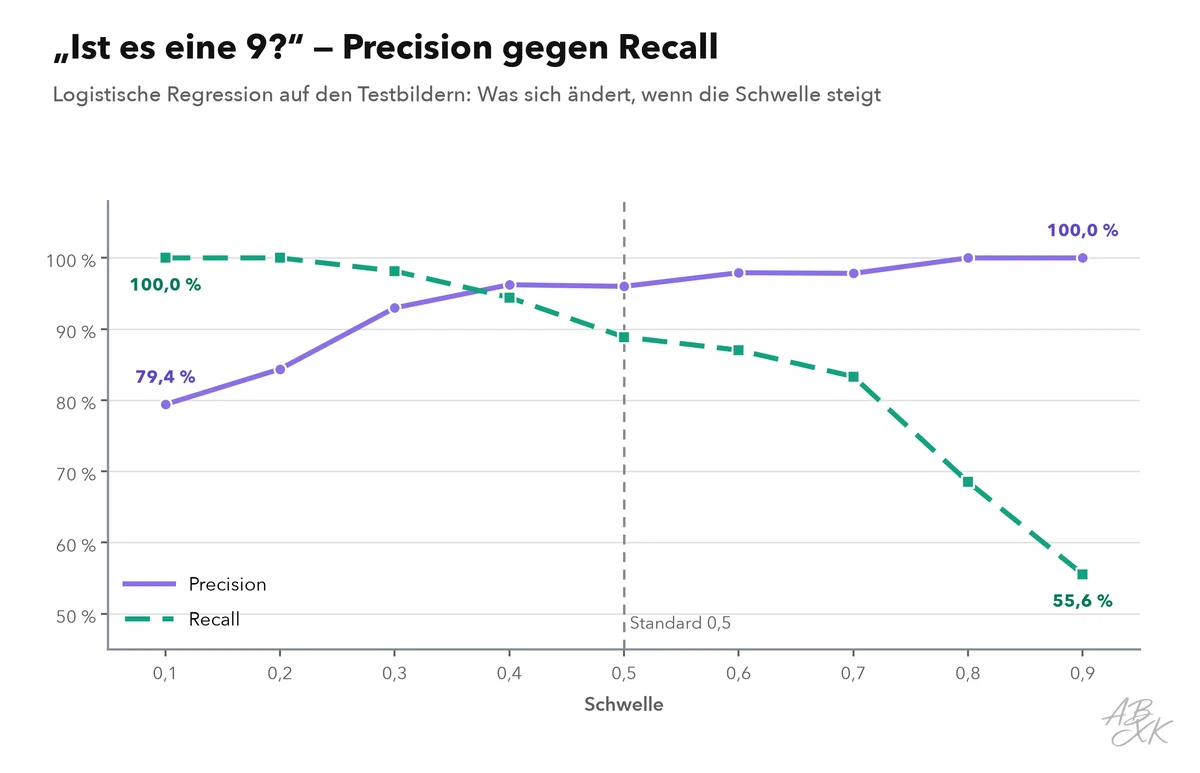
Bei einer niedrigen Schwelle von 0,1 fand das Modell jede 9, ein Recall von 100 %, doch seine Precision lag nur bei 79,4 %. Bei einer hohen Schwelle von 0,9 war jedes markierte Bild wirklich eine 9, eine Precision von 100 %, aber es übersah viele: Der Recall fiel auf 55,6 %. Gleiches Modell, gleiche Daten, ganz anderes Verhalten. Die Schwelle ist eine der wichtigsten Einstellungen jedes Klassifikators, und der Standardwert 0,5 ist für einen echten Geschäftsfall selten der richtige.
| Schwelle | Precision | Recall | Fehlalarme | Übersehene 9en |
|---|---|---|---|---|
| 0,1 | 79,4 % | 100,0 % | 14 | 0 |
| 0,3 | 93,0 % | 98,2 % | 4 | 1 |
| 0,5 | 96,0 % | 88,9 % | 2 | 6 |
| 0,7 | 97,8 % | 83,3 % | 1 | 9 |
| 0,9 | 100,0 % | 55,6 % | 0 | 24 |
Eigenes Experiment: Datensatz Optical Recognition of Handwritten Digits (E. Alpaydin, C. Kaynak, UCI Machine Learning Repository, Lizenz CC BY 4.0), 1797 Bilder je 8 × 8 Pixel, davon 540 zum Testen zurückgehalten; scikit-learn 1.9.1, fester Zufallsstartwert — jeder Lauf ergibt dieselben Zahlen.
Was Sie bei jedem Klassifikator fragen sollten
Wenn jemand einen Klassifikator vorstellt, bringen diese Fragen Sie an der Schlagzeile vorbei:
- Wie wurde getestet? Nur Ergebnisse auf Daten, die das Modell nie gesehen hat, zählen.
- Wie häufig ist jede Kategorie? Bei seltenen Kategorien ist die Genauigkeit fast bedeutungslos.
- Welche Fehler passieren? Fragen Sie nach der Konfusionsmatrix, nicht nur nach einer Zahl.
- Precision oder Recall? Welche Fehlerart ist in Ihrem Prozess teurer, und ist die Schwelle danach eingestellt?
- Was prüft ein Mensch? Bei teuren Entscheidungen sollten unsichere Fälle nahe der Schwelle an einen Menschen gehen.
Der nächste Teil zeigt einen Klassifikator, der auf seinen Trainingsdaten perfekt abschneidet und trotzdem versagt: den Entscheidungsbaum und das Problem der Überanpassung.